过去两年,AI Agent 的讨论重点一直集中在一个问题:怎样让 Agent 更强?于是,我们给 Agent 接入更强的大模型、RAG、Memory、MCP、Browser、Code Interpreter,设计 Planner、Reflection、Multi-Agent……Agent 能做的事情越来越多。
但当 Agent 真正进入生产环境,一个比“能不能做”更难的问题出现了:它为什么这么做?它看到了什么?哪一步出了问题?最后到底做得好不好?新版本真的比旧版本更好吗?
如果这些问题无法回答,一个看起来很聪明的 Agent,本质上仍然是一个难以控制的黑盒。因此,2026 年值得重点关注的 Agent 技术主线,正在从单纯的 Agent Runtime 向一套完整的质量工程体系延伸:
Observation → Tracing → Observability → Evaluation → Debugging → Regression → Optimization。
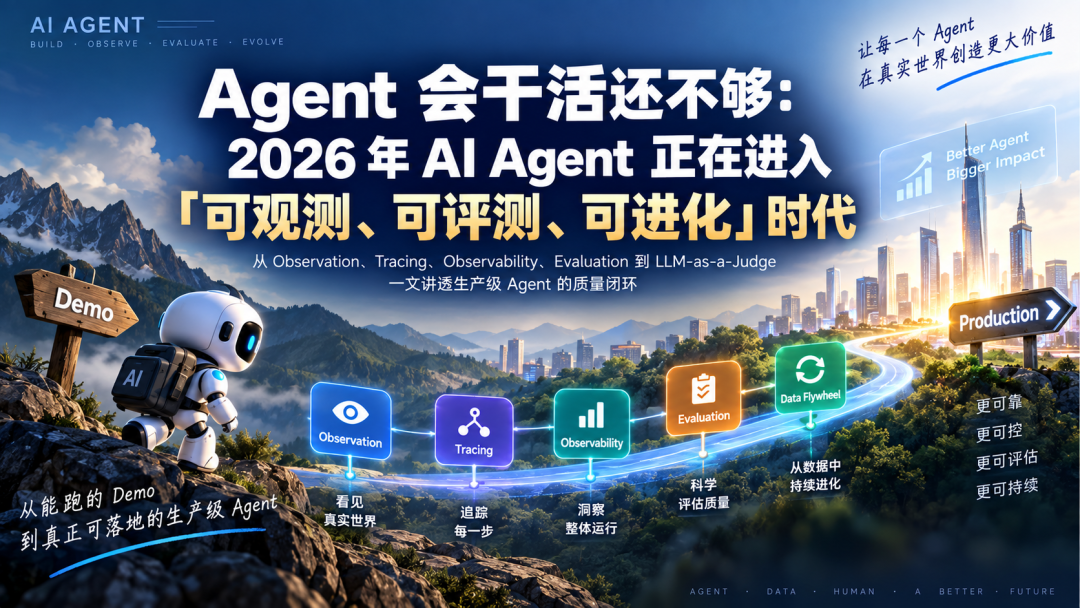
01、Agent 能跑起来之后,真正的问题才刚刚开始
一个 Demo Agent 很容易让人惊艳:
但生产环境中的 Agent 往往是:
链路越长,失败模式越多。一次错误可能来自 Planner 错误拆解、Tool 选择错误、参数错误、检索不完整、Observation 被误解、Memory 过期,甚至 Agent 已经拿到正确证据,却在最后推理时产生幻觉。
因此,生产级 Agent 必须回答五个问题:Agent 看到了什么?做了什么?做得怎么样?为什么失败?下一版怎样更好?
核心变化:Agent 工程正在从“能力工程”走向“质量工程”。
02、Observation:Agent 如何感知外部世界
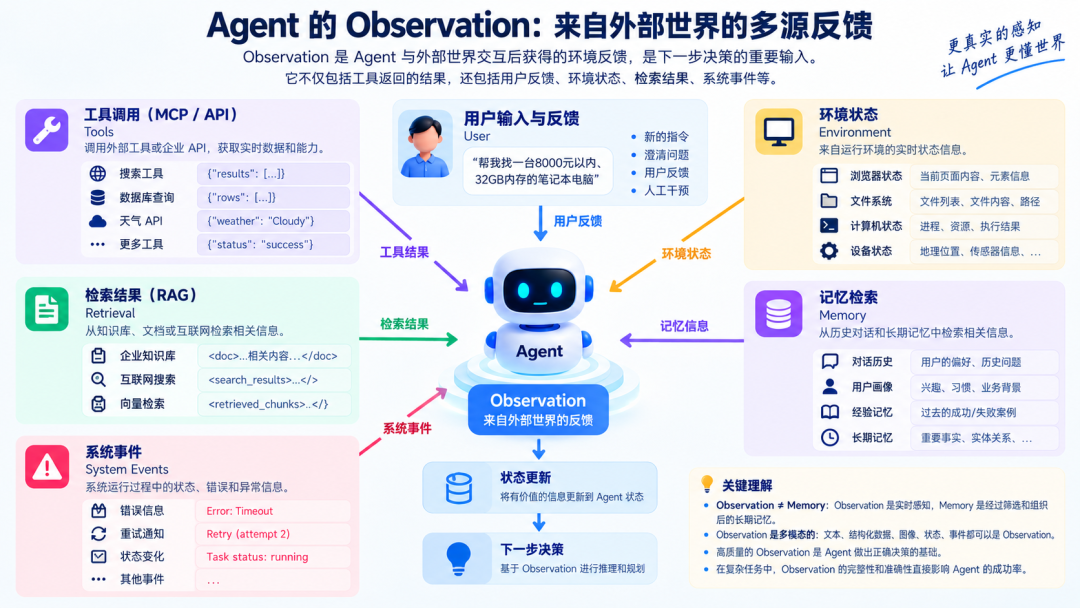
很多人第一次看到 Observation,会把它理解成“工具调用返回值”。这并不完整。Observation 是 Agent 与外部世界发生交互后得到的环境反馈,是下一步决策的重要输入。
Agent 下一轮决策应该建立在这个 Observation 上。这也是 Agent 和普通 Chatbot 的重要区别:Agent 不只是生成 Token,而是在不断执行“行动—观察—决策”的循环。
Observation ≠ Memory 可以简单理解为:Observation 回答“刚刚发生了什么”;Memory 回答“过去哪些信息值得继续记住”。
并不是所有 Observation 都应该写入 Memory。一次 API 超时、页面临时状态、无价值搜索结果,如果全部进入长期记忆,最终会导致记忆污染、上下文膨胀和错误信息累积。
03、Tracing & Observability:让 Agent 从黑盒变成白盒
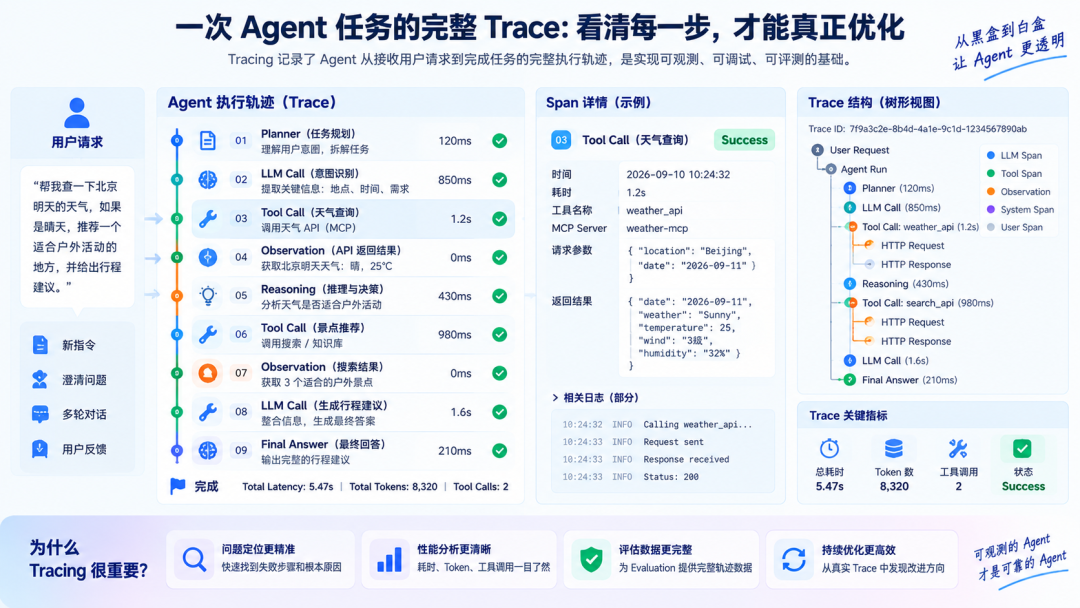
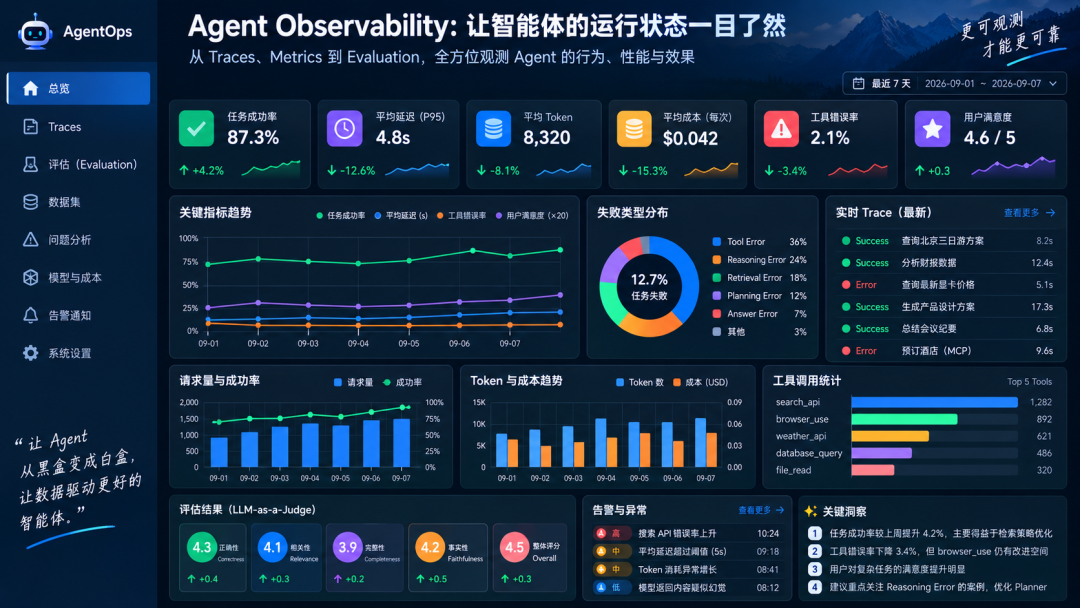
Observation 是 Agent 看到了什么;Observability 则是 工程师能不能看清 Agent 到底发生了什么。
这中间最重要的基础能力就是 Tracing。一次 Agent 请求可以看成一个 Trace,每一步执行看成一个 Span:
Span 可以记录 model、input/output、tool_name、arguments、observation、latency、token、cost、status、error、retry 等信息。
这样,当用户说“Agent 为什么回答错了”,工程师不再只能盯着最终答案猜原因,而可以沿 Trace 一步步还原现场。
这一层值得重点关注的技术包括:OpenTelemetry、Langfuse、Arize Phoenix、LangSmith、Grafana、Jaeger/Tempo,以及 ClickHouse、PostgreSQL、Kafka 等数据基础设施。
但 Observability 只能告诉你:
它不一定能回答:这个答案究竟好不好?工具虽然调用成功了,但真的应该调用它吗?于是必须进入下一层:Evaluation。
04、Evaluation:如何判断 Agent 到底做得好不好
传统软件测试喜欢:
但生成式 AI 很难这么做。“帮我设计一个北京三日游方案”可能存在几十种优秀答案,只比较字符串是否相等没有意义。
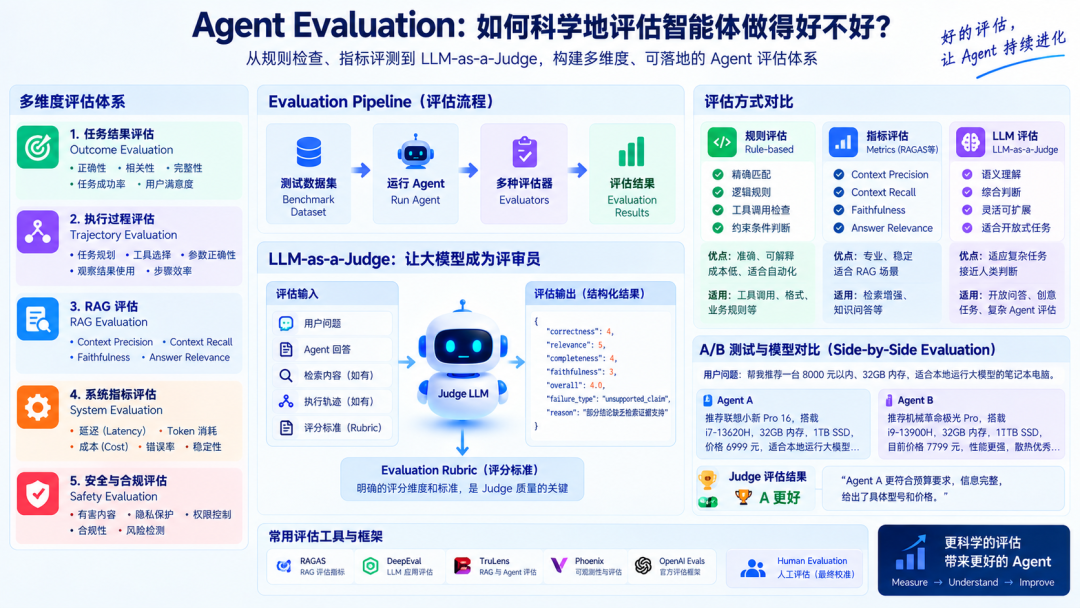
因此,Agent Evaluation 必须是多维度的。
1. Outcome Evaluation:结果好不好
关注 Correctness、Relevance、Completeness、Task Success 等最终结果指标。
2. Trajectory Evaluation:过程走得对不对
这是 Agent Eval 与普通 LLM Eval 最大的区别之一:不仅看答案,还要看 Planner 是否合理、Tool Selection 是否正确、Tool Arguments 是否正确、Observation 是否被正确使用、有没有无意义 Loop、有没有多余步骤。
最终答案错了,Root Cause 可能发生在数据库工具参数构造阶段。
3. RAG Evaluation:知识链路是否可靠
典型指标包括 Context Precision、Context Recall、Faithfulness、Answer Relevance。Ragas 等工具属于这一层。
4. System Evaluation:工程表现怎么样
Latency、Token、Cost、Error Rate、Retry Rate、Tool Call Count 都应该进入评测。一个正确率提升 1%,但成本上涨 300%、延迟翻倍的 Agent,不一定是更好的生产方案。
5. Safety Evaluation:它能不能被放心授权
当 Agent 能操作浏览器、代码仓库、企业数据库、邮件和 MCP Server 后,Evaluation 还必须覆盖权限边界、敏感数据、Prompt Injection、Tool Injection、危险操作和 Human Approval。
因此,一个成熟的 Agent Scorecard 应该同时包含:Quality + Trajectory + Retrieval + Reliability + Cost + Latency + Safety。
05、LLM-as-a-Judge:让大模型成为 Agent 的自动评审员
LLM-as-a-Judge:它不是 Agent Evaluation 的全部,而是其中一种非常重要的 Evaluator。很多质量问题无法通过简单规则判断,例如:“这个回答是否真正理解用户意图?”“A、B 两个方案哪个更完整?”“Agent 虽然完成任务,但整个执行过程是否合理?”
于是可以让另一个能力较强的 LLM 根据 Rubric 评分:
例如:
能用规则判断的,不要全部交给 Judge
生产级 Eval 更合理的组合是:
Rules + Metrics + LLM Judge + Human Calibration。
SBS:Judge 最有价值的应用之一
Agent V2 换了新模型、Prompt 或 Memory 策略,怎么证明比 V1 好?
这就是 Side-by-Side Evaluation(SBS)。1000 个 Case 最终可能得到:V1 Win 27%、V2 Win 61%、Tie 12%。这显然比“工程师试了几个问题,感觉 V2 更聪明”可靠得多。
Judge 自己也会犯错
LLM Judge 不是 Ground Truth。它可能存在 Verbosity Bias、Position Bias、Self-preference、专业领域知识错误和 Score Drift。
因此高质量 Judge 系统需要:明确 Rubric、结构化输出、交换 A/B 顺序、人工 Golden Set 校准,以及必要时使用多个 Judge 做一致性检查。
06、从 Debugging 到 Data Flywheel:Agent 真正的竞争力是持续进化
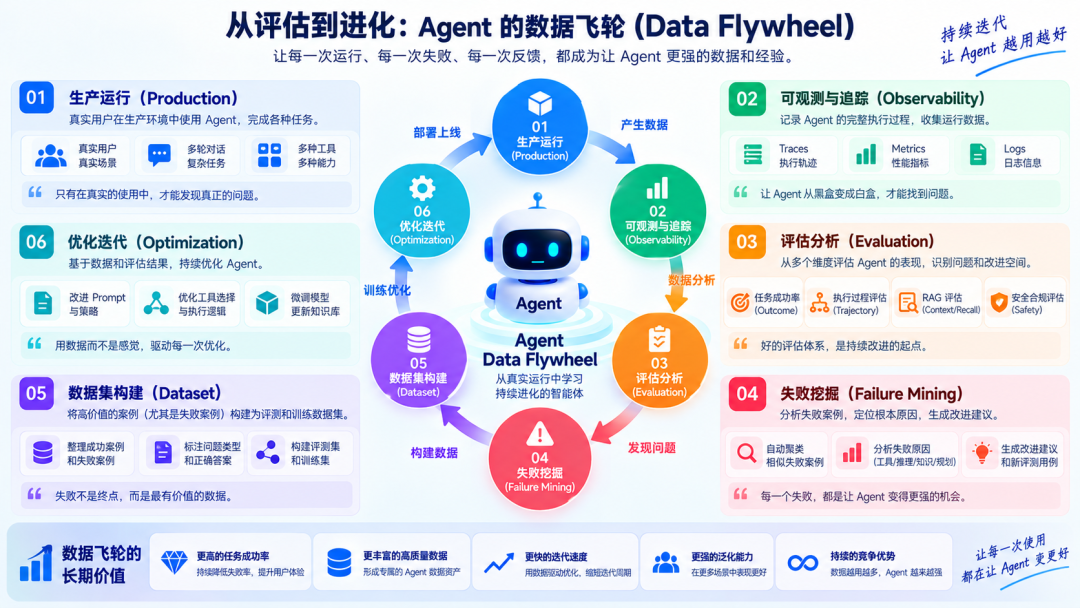
如果把 Observation、Tracing、Observability、Evaluation 和 Judge 串起来,会出现一个非常有价值的闭环。假设线上每天运行 100 万次 Agent 请求,人工不可能逐条检查,但系统可以自动完成:
这就是 Agent Data Flywheel。
Failure Taxonomy 很重要
不要只记录 success = false,而应该进一步归因:
数据积累后,团队可能发现最近 7 天失败请求中,31% 来自 Tool Selection、22% 来自 Retrieval、17% 来自 Tool Arguments……这时才能真正回答:下一版本应该优化哪里?
这也是 Agent Observability 真正的价值:不是为了做一个漂亮 Dashboard,而是为了驱动系统进化。
Regression Detection:Agent 也需要自己的“单元测试”
每次修改 Prompt、Model、Tool、Memory、Context Strategy,都可能带来局部提升和其他能力退化。因此可以把 Eval 接入 CI/CD:
例如:
| Metric | V1 | V2 |
| Task Success | 82% | 88% |
| Tool Accuracy | 91% | 94% |
| Hallucination | 8% | 4% |
| Avg Steps | 4.2 | 5.1 |
| Latency | 2.8s | 3.2s |
| Cost | $0.03 | $0.04 |
V2 的质量更高,但步骤、延迟和成本也增加。真正的工程决策不是“88% 大于 82%,所以发布”,而是结合业务 SLA、成本和风险综合判断。
07、写在最后:2026 年 Agent 的分水岭,不再只是“聪不聪明”
回头看整条链路:
过去我们关注的是:Agent 能不能调用工具、能不能完成任务。而生产级 Agent 更关心:它为什么这么做?我们能否看清过程?能否量化质量?失败能否归因?版本升级能否证明没有退化?线上经验能否反过来让 Agent 持续变好?
因此,2026 年真正值得工程团队投入的,不只是“再做一个 Agent Framework”,而是围绕 Agent 建立一套完整的 Observability + Evaluation + Debugging + Data Flywheel。
LLM-as-a-Judge 很重要,但它只是其中的一块拼图。真正强大的 Agent 系统应该做到四个关键词:
可观测(Observable):知道 Agent 做了什么。
可评测(Evaluable):知道 Agent 做得怎么样。
可调试(Debuggable):知道 Agent 为什么失败。
可进化(Evolvable):知道下一版应该怎么变得更好。
当 Agent 从“Demo 能跑”走向这四个目标,才真正开始进入生产级 AI Engineering。
08、技术栈速查
| 层次 | 推荐关注技术 |
| Agent Runtime | LangGraph、LangChain、自研 Runtime |
| Tool / Protocol | MCP、Function Calling、A2A |
| Tracing | OpenTelemetry |
| Observability | Langfuse、Arize Phoenix、LangSmith、Grafana |
| Evaluation | Ragas、DeepEval、Promptfoo、自研 Evaluator |
| Semantic Eval | LLM-as-a-Judge、SBS / Pairwise Eval |
| Data | PostgreSQL、ClickHouse、Redis、Kafka |
| Regression | Pytest、CI/CD、Benchmark Dataset |
| Deployment | FastAPI、Docker、Kubernetes |
一句话:Agent 的上半场是“让它会做事”,下半场是“让它可靠地把事情做好,并且能够持续证明自己变得更好”。
文章来自:51CTO
