2026年的开发者圈子里,一个共识正在形成:当Cursor估值突破500亿美元、Claude Code上线8个月即成为最受开发者欢迎的工具、SWE-bench Verified公开模型最高分达到87.6%时,”AI能不能写代码”已经不是问题了。真正的问题变成了:你能不能让AI替你端到端地完成一个开发任务——从需求描述到测试通过,你只在关键节点做确认。
这就是AI编程Agent。不同于过去”补全一行代码”的Copilot模式,Agent的核心特征是:它接收一个模糊意图,自行拆解步骤、调用工具、生成代码、运行验证,最终交付可用结果。
本文不讲概念,只讲怎么落地。
一、先搞清楚:Agent和普通AI编程工具有什么不同
维度 | 传统AI辅助(Copilot模式) | AI编程Agent
交互方式 | 人写一行,AI补下一行 | 人说一个任务,AI自主执行多步
上下文管理 | 当前文件+光标附近 | 整个项目目录+Git历史+测试报告
能力边界 | 生成代码片段 | 规划→编码→运行→调试→提交
人的角色 | 主导编写 | 定义问题+验证结果
典型工具 | GitHub Copilot(早期) | Cursor 3 / Claude Code / Windsurf
关键认知转变:开发者角色从”代码编写者”变成”任务编排者+质量审计员”。
二、工欲善其事:三种主流路径的选择
目前最实用的AI编程Agent工具主要有三类路径,适合不同场景:
路径一:Cursor(IDE内Agent)
适合场景:已有项目、需要频繁交互式开发、前端/全栈项目。
Cursor 3的核心升级是将IDE从”文件树+编辑器”重构为”任务流+Agent控制台”。你不再告诉AI”在当前光标位置补全代码”,而是说”给这个模块加上分页查询功能,保持现有API风格一致,写完跑一遍单元测试”。
路径二:Claude Code(CLI Agent)
适合场景:后端服务、脚本任务、批量处理、远程服务器操作。
Claude Code的惊人之处在于效率对比:用GitHub CLI审查一个PR约消耗200 tokens,而通过MCP协议连接GitHub API做同样的事需要55000 tokens,差距高达275倍。CLI Agent天然就是”代码和命令行为原生接口”,不走中间层。
路径三:自建Agent工作流(框架级)
适合场景:高度定制化、需要对接内部系统、多步复杂流程。
用LangGraph/CrewAI等框架搭建自定义Agent pipeline,对接内部API、数据库和CI/CD系统。
三、实战:用Claude Code完成一个完整开发任务
以下演示如何用Claude Code CLI工具从零完成一个”给现有Python项目添加缓存层”的任务。
步骤1:安装与配置
npm install -g @anthropic/claude-code
claude auth # 浏览器完成OAuth认证
进入项目目录后,Claude Code会自动读取项目结构、package.json/requirements.txt、README和.gitignore作为初始上下文。
步骤2:用自然语言描述任务
claude “为这个Flask项目的所有数据库查询添加Redis缓存层。要求:
1. 使用cache-aside模式
2. 默认TTL设为300秒
3. 写一个缓存装饰器,保持业务代码不侵入
4. 添加单元测试覆盖缓存命中/未命中/过期三种情况
5. 确保现有测试全部通过”
步骤3:Agent自主执行
Claude Code会依次:
1. 扫描项目结构,识别所有数据库查询位置
2. 规划实现步骤,展示给你确认
3. 编写装饰器代码
4. 修改调用点,应用装饰器
5. 编写测试用例
6. 执行pytest,检查结果
7. 如果测试失败,自动分析错误、修正代码、重新运行
你全程只需要在步骤2的规划节点做一次”确认/修改/拒绝”的选择。
步骤4:验证交付物
git diff # 审查Agent所有修改
pytest -v # 本地跑一遍全部测试
关键原则:永远不要跳过审查步骤。Agent能生成代码,但架构决策、安全边界、业务语义的正确性仍需人类判断。
Claude Code 完成一次「加缓存层」任务的六个阶段:读取项目→规划(唯一人工确认点)→编码→跑测试→迭代修复→交付(流程为示意,非真实终端截图)。
四、进阶技巧:让Agent产出质量翻倍的五个实践
技巧1:写清楚约束,而非只写需求
差的任务描述:”帮我加个用户登录功能”
好的任务描述:”在现有的FastAPI项目中实现JWT登录。约束:密码用argon2哈希,token有效期2小时,需要兼容现有的User模型(不要修改数据库schema),错误码遵循RFC7807标准,不要引入新的外部依赖。”
约束越清晰,Agent返工率越低。
技巧2:分治策略——拆小任务而非塞大任务
一次让Agent做5000行代码的项目骨架,不如分5步各做1000行:数据模型→API路由→业务逻辑→测试→文档。每步完成后跑测试确认,再进入下一步。
实测数据显示:将大任务拆分为3-5个小步骤后,Agent一次性通过率从约40%提升到70%以上。
技巧3:利用项目级配置文件
在Cursor中,.cursorrules文件可以让Agent遵循你的编码规范。在Claude Code中,项目根目录放一个CLAUDE.md,写明技术栈、命名规范、禁止事项。
# CLAUDE.md 示例
– Python 3.11+, 所有函数必须有type hints
– 禁止使用print(), 统一用structlog
– 数据库操作必须通过Repository层,不得在Service层直接写SQL
– 测试命名格式: test_<函数名>_<场景>_<期望结果>
技巧4:建立验证反馈环
Agent最大的失败模式是”自信地生成错误代码”。解决方案:把测试覆盖率检查、lint规则、类型检查作为每步执行的必过关卡。在CI pipeline中加入”AI生成代码必须附带对应测试用例”的门禁。
技巧5:知道什么时候该人工介入
以下场景Agent仍不可靠,需要人主导:
• 系统架构设计(服务拆分、数据流方向)
• 安全敏感操作(权限模型、密钥管理、SQL注入防御)
• 跨团队API契约变更
• 性能瓶颈的非显而易见优化
五、行业数据:AI编程Agent走到哪一步了
• SWE-bench Verified(业界标准的”真实GitHub Issue修复”基准)公开模型最高分:87.6%(Anthropic Opus 4.7,2026年4月发布)
• 受限内测模型Mythos Preview得分:93.9%(仅对11家安全伙伴开放)
• 开源模型阵营:DeepSeek-V4约82%、Qwen3-Coder约80%——与商业前沿差距缩小到5个百分点以内
• Claude Code商业表现:上线8个月,年收入据报达25亿美元级别(厂商自报数据,未经第三方审计)
• Cursor估值:2026年突破500亿美元
这些数字说明两件事:第一,AI Agent处理真实编程任务的能力已经到了”大部分场景可用”的水平;第二,”用哪个模型”已经不重要了——六大主流模型在公开评测上的差距压缩到1个百分点以内。决定产出质量的不再是模型版本,而是你给它的上下文质量、任务拆解方式和验证流程。
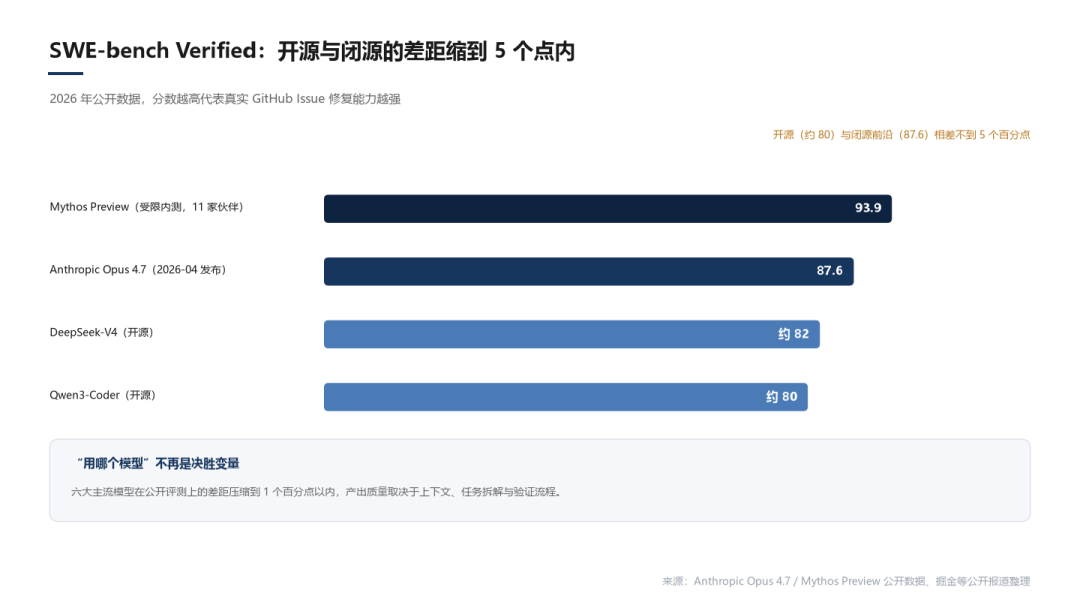
SWE-bench Verified 公开数据:Mythos Preview 93.9%(受限内测)、Opus 4.7 87.6%、DeepSeek-V4 约 82%、Qwen3-Coder 约 80%,开源与闭源前沿差距不到 5 个百分点。
六、常见误区与风险提示
误区一:”Agent能替代程序员了”
现实:Agent能替代的是”重复性编码”环节,但需求分析、架构设计、跨团队协调、线上故障排查——这些工作的本质不是”写代码”,而是”定义问题”。Agent擅长解决问题,但定义什么问题、解决到什么程度算好,仍然是人的判断。
误区二:”Agent生成的代码可以直接上生产”
现实:任何AI生成的代码在上线前必须经过:人工代码审查、完整测试覆盖(不只是Agent自己写的测试)、安全扫描、性能基准对比。把Agent当成”高效初级程序员”来对待——能力不错,但不可信任。
误区三:”用Agent就不用学编程了”
现实恰恰相反。使用Agent的门槛不是降低了,而是升高了——你需要能判断Agent输出的正确性、能写出清晰的约束文档、能设计有效的验证流程。一个不懂编程的人用Agent,和一个资深工程师用Agent,产出质量差距是数量级的。
结语
AI编程Agent不是未来,是现在。但它的正确打开方式不是”扔一个模糊需求进去然后等着”,而是构建一套”人类定义边界+AI执行中间+双方验证结果”的协作流程。谁先把这个流程跑通,谁就能在开发效率上拿到倍数级的提升。
读者互动:你目前用什么AI编程工具?有没有遇到过Agent”自信地犯大错”的经历?欢迎在留言区分享你的踩坑故事或高效实践。

