一、为什么这次升级值得开发者花时间重读文档
2026年11月9日深夜,Anthropic 发布 Claude Fable 5.2 与 Claude Mythos 5.2。两款模型共用同一底层权重,差异体现在安全护栏与准入策略:Fable 面向所有付费用户开放,Mythos 仅向通过 Cyber 或 Life Sciences 验证计划的机构开放。对绝大多数开发者而言,能直接接触的是 Fable 5.2。

官方公布的核心跑分(均为 Anthropic 自报口径、第三方独立复核尚未出来)显示,Fable 5.2 在多项长程任务基准上实现代际跃升:FrontierCode 2.0 从 5.1 的 32.4% 提升至 49.1%(Xhigh effort),FrontierSWE v2 从 56.3% 提升至 69.9%,Terminal-Bench-Science 0.1 从 52.6% 提升至 74.6%,双臂机器人仿真基准 RoboDojo Sim 从 27.6% 提升至 64.9%,Remote Labor Index 从 17.9% 提升至 41.3%(High effort)。更值得关注的是长程任务演示:官方披露 1000 多个子智能体连续协作 8 天,从空文件夹构建出可在笔记本上启动的操作系统原型;另一次实验中,约 1000 个智能体耗时约 30 小时完成费马大定理证明的 Lean 形式化,而此前研究版 Claude 完成同类任务需要 11 天并依赖人工引导。
价格侧同步下调:标准API每百万输入token 8美元、输出40美元,较 5.1 的 10/50 下降20%;输出速度最高提升30%;另设 Fast Mode,速度提升至标准模式的2.5倍,价格翻倍至16/80美元。模型规格为100万token上下文、12.8万token最大输出、adaptive thinking 常开,思考深度由 effort 参数控制,从 Low 到 Max 共五档,Medium 是 Claude App 与 Claude Code 的默认档。
但真正会让现有集成”跑不通”的,不是这些能力数字,而是四处破坏性API变更。下面按”迁移清单—选型策略—实操模板”三层展开。
二、四处400级破坏性变更,先看再改
以下细节综合 Anthropic 官方公告页与迁移指南(部分为第三方转述,官方 docs 站在中国大陆地区访问受限)。
第一处:preserved thinking 前缀校验全面铺开。 每个 thinking block 会记录产生它的会话前缀与模型身份,API 会校验思考块之前的 system、tools 和历史消息有没有被动过。改过又未声明处理策略的请求直接返回 400,错误信息为”The block is bound to a different conversation”。此前该功能仅对”2026年8月31日后新建账号”生效,本次扩大到全部账号。如果你的 agent 循环会在会话中途调整 system prompt 或动态增删工具,旧账号上今天能跑通的代码,切到 5.2 就会 400。
第二处:thinking block 跨模型静默丢弃。 5.2 的 thinking block 只有 Fable 5.2 和 Mythos 5.2 能读,回退到旧模型(包括 Opus 5.5)时块被静默丢弃,不报错但不计费。这意味着多模型编排系统里,如果 Fable 5.2 产生的思考块被下游 Opus 5.5 接手,上下文会丢失。
第三处:computer_20251124 旧工具形式全平台报错。 除 AWS Bedrock 外,其他平台只认新的 toolset 形式。桌面 GUI 自动化类集成需要重写工具注册逻辑。
第四处:advisor tool 仍处 beta,executor 升到 5.2 后 advisor 必须同级以上。 多模型协作场景中,如果 executor 是 Fable 5.2,advisor 不能是更低版本的模型。
另有两处静默变更:强制 30 天数据保留,ZDR(Zero Data Retention)需单独授权;thinking block 只在产出它的账号(或关联账号)内有效。
逃生舱是 beta header 加 prefix_mismatch_behavior 设为 drop_block,但官方明说这是权宜之计——丢块会推高输出 token,账单会明显上浮。
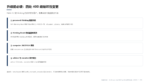
升级到 Fable 5.2 前必须核对的四处破坏性变更。
三、effort 五档怎么读:跑分要连着档位一起看
Fable 5.2 的 adaptive thinking 常开、无法关闭,但推理深度由 effort 参数控制,从 Low 到 Max 五档。读跑分表时容易踩的坑是:同一型号在不同 effort 下的分数差距,可以大到像两个模型。
以 FrontierCode 2.0 为例:Fable 5.2 在 High effort 下得分 45.3%,与 Opus 5.5 Max 档的 45.5% 基本持平,官方报告的每任务成本约为后者一半;Fable 5.2 在 Xhigh effort 下才到 49.1%。对比别人的榜单时,先确认双方 effort 对齐,再谈谁强。
官方给出的另一组成本参考更直观:WANDR 上,Fable 5.2 用 Medium 档就追平 Opus 5.5 的最高分,每任务成本约为四成;Humanity’s Last Exam 上,用 Low 档就追平 Opus 5.5 的最高分,成本不到十分之一;Chartography 图表识别上,用 Medium 档得 66.4%,高于 Opus 5.5 最高档的 64.4%,成本不到十分之一。
选型建议按任务复杂度分层:日常编码与知识工作先用 Opus 5.5(4/20美元);复杂度上来再切 Fable 5.2 High 档(8/40美元);长程智能体任务、跨文件大型重构、机器人控制与 computer use 场景,才考虑 Xhigh 或 Max 档;简单任务下探 Sonnet 5.5(2/10美元)或 Haiku。Anthropic 官方在公告里写得很直白:大多数时候你不需要 Fable。
四、Advisor 与 Orchestrator:多模型协作的两种官方姿势
Fable 5.2 第一次把”多模型协作”从工程实践变成官方 API 能力,支持两种角色定位:
Advisor(顾问模式):小模型遇到难题时来问 Fable。典型场景是 Haiku/Sonnet 处理大量常规请求,遇到复杂推理或架构决策时把上下文打包发给 Fable,拿到结论后继续执行。这种模式下 Fable 的调用频次低、单次价值高,适合做”技术负责人”角色。
Orchestrator(编排模式):Fable 把简单子任务派给小模型。典型场景是长程项目,Fable 负责规划、拆解、验收,具体执行由 Sonnet/Haiku 完成。这种模式下 Fable 的 token 消耗集中在 planning 与 review 环节,执行成本被显著摊薄。
两种模式可以组合。Anthropic 官方演示的”1000个子智能体8天造操作系统”案例,本质上就是一个 Orchestrator + 大量 executor 的架构:Fable 5.2 做顶层规划与模块划分,子智能体负责具体编码、测试与审查。
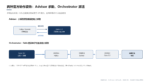
Fable 5.2 的 Advisor 与 Orchestrator 两种官方协作模式。
五、一段可直接抄的 Python 调用模板
以下是基于 Anthropic 官方 SDK 的最小可运行示例,覆盖 effort 参数、thinking block 处理与多模型协作三种常见场景。
import anthropic
client = anthropic.Anthropic() # 从环境变量 ANTHROPIC_API_KEY 读取
场景1:单模型长程任务,显式指定 effort
response = client.messages.create(
model=”claude-fable-5-2″,
max_tokens=8192,
extra_body={“thinking”: {“type”: “enabled”, “effort”: “high”}},
messages=[{
“role”: “user”,
“content”: “分析当前微服务架构的性能瓶颈并给出 Rust 重构方案,要求跨文件依赖完整梳理。”
}]
)
注意:返回体默认包含 thinking 块,需要过滤
final_text = next(b.text for b in response.content if b.type == “text”)
场景2:Advisor 模式——小模型遇到难题时求助 Fable
def advisor_call(haiku_context: str, question: str) -> str:
resp = client.messages.create(
model=”claude-fable-5-2″,
max_tokens=4096,
extra_body={“thinking”: {“type”: “enabled”, “effort”: “medium”}},
system=”你是资深架构顾问,只回答关键决策问题,不重复上下文。”,
messages=[{“role”: “user”, “content”: f”背景:{haiku_context}n问题:{question}”}]
)
return next(b.text for b in resp.content if b.type == “text”)
场景3:保留 thinking block 的多轮会话
关键:不要修改 thinking block 之前的 system/tools/history
messages = [{“role”: “user”, “content”: “设计一个分布式任务调度系统”}]
r1 = client.messages.create(model=”claude-fable-5-2″, max_tokens=8192, messages=messages)
把完整返回(含 thinking)追加到 messages,下一轮原样传回
messages.append({“role”: “assistant”, “content”: r1.content})
messages.append({“role”: “user”, “content”: “把调度器换成基于 Raft 的实现”})
r2 = client.messages.create(model=”claude-fable-5-2″, max_tokens=8192, messages=messages)
三个容易踩的坑:其一,extra_body 里的 thinking 配置在不同 SDK 版本中字段名可能略有差异,以官方最新文档为准;其二,多轮会话中如果动态增删 tools,必须显式声明 prefix_mismatch_behavior,否则会撞 400;其三,Fast Mode 需要在请求头里单独开启,价格是标准模式的2倍,适合延迟敏感的交互式 agent,不适合批量后台任务。
六、反蒸馏与训练期能力削平:两个容易被忽略的产品信号
Fable 5.2 的另一层变化在安全与治理侧。官方口径是”史上最强的蒸馏防护”,结合已披露技术,蒸馏者能拿走的数据减少了90%到99%。保留思考覆盖所有 API 账户后,”重写上文逼模型吐推理链”这条路被从协议层封死。一场围绕训练数据的风控战,已经打成了产品功能。
更罕见的是:Anthropic 在训练期主动削平了模型加速 AI 研发的能力。在加速器 kernel 优化和 LLM 架构改进这两个方向上,5.2 被刻意压到与 Opus 5.5 持平,尽管其他维度全面超越;限制做在训练里而不是推理时,对少量话题透明回退到 Opus 5。agentic coding、硬件开发、可解释性研究不受影响。
一家公司把”不给模型自己加速研发”写进训练目标,是能力克制第一次以这种方式落地。它能不能长期有效(比如模型是否能把这两个方向的知识藏在别的任务里迁移出去)是开放问题,公告没有回答。对开发者而言,这意味着在特定领域(如 CUDA kernel 优化、模型架构搜索)调用 Fable 5.2 可能得不到预期中的”代际提升”,需要实测验证。
七、一份可执行的迁移清单
给正在评估切换的团队一份最小行动清单:
盘点现有 agent 循环:是否会在会话中途调整 system prompt 或动态增删 tools?如果是,先加 prefix_mismatch_behavior 逃生舱,再规划重构。
核对 computer use 集成:是否还在用 computer_20251124 旧工具形式?除 Bedrock 外全平台报错,需要重写为 toolset 形式。
多模型编排对齐版本:advisor 与 executor 必须同级以上,检查现有编排图里是否存在版本错配。
小流量灰度:抽取自身真实业务日志中的高难 Bad Cases,围绕端到端任务一次通过率、首字响应延迟(TTFT)以及包含 thinking tokens 在内的真实账单成本做一轮对比测试。
账单口径切换:从”每百万token”切换到”每件任务”。官方给出的成本参考(High 档打平 Opus 5.5 Max、账单约一半)是营销口径,实际任务上的性价比需要自己测。
价格锚点正在从每百万token滑向每件任务。同期 OpenAI 的 GPT-6.1 Sol 主打缓存输入 0.1 美元,Meta 的 Muse Ember 打到 0.004 美元,三家都在讲缓存命中率和任务成本。买模型的 CFO 们很快会换一套算账方式。

