模型竞争的重心,正在从”单点最强”转向”分层+编排”。11月12日,谷歌发布Gemini 4 Hydrogen,把它定位为Gemini 4家族里的”高频执行层”——负责日常写代码、跑测试、核对改动、检索资料、串联工具调用的智能体工作流,与专攻长程深度推理的Carbon、Argon分工协作。同日,它接替Gemini 3.8 Flash成为Google Search与AI Mode的默认模型,并配套上线了Antigravity中的Orchestrator多模型编排能力。对开发者而言,这不是”又一个更强的模型”,而是一套可以直接落地的工作流方法论。
关键规格:执行层的性价比逻辑
Hydrogen的定价与上下文策略,是围绕”高频调用可承受”设计的:每百万输入token 1.50美元、输出7.50美元,且整个100万token上下文窗口统一计价、不分段阶梯(IT之家注:按现汇率约合输入10元、输出50.1元)。它原生支持100万token输入、最多100万token输出,长上下文不再额外加价——这意味着把整个代码仓或长篇技术文档一次性喂进去做执行,成本模型依然成立。
据谷歌官方口径,相较2026年9月的Gemini 3.8 Flash,Hydrogen在默认高档下完成任务快2.5倍,Terminal-Bench 4.1从18.2%升至57%,虚假陈述减少5倍以上;在Artificial Analysis智能指数中,默认高档得51分(略高于Argon的50),最高xhigh档达54分。需强调:上述所有数据均来自谷歌官方博客与模型卡,属发布方自测口径,未经第三方独立复现。
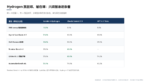
Hydrogen赢在仓库编码与知识工作、输在终端与图形界面操作,”分工”取代”总分”成为新比较维度(数据来源:谷歌官方博客,发布方自测口径未经第三方复现)。
五步上手:从选型到编排
第一步,搞清楚在哪用。Hydrogen已面向Google AI Studio所有层级用户、Gemini API开发者、Gemini for Business企业用户与Gemini app开放,并整合进Google Search;订阅Google AI Pro与Ultra的用户,还可在Google Antigravity中调用。普通用户在搜索与Gemini app里已默认用上它。
第二步,建立分工判断法。把任务分成两类:一类是”难题”——系统架构判断、排查疑难bug、长程自主推理,交给Carbon或Argon;另一类是”体力活”——写代码、跑测试、验证改动、批量检索、串联工具调用,交给Hydrogen。谷歌的说法很直白:一个团队既需要前沿模型做架构判断,也需要一个快速、守纪律的执行模型来落地。
第三步,用Orchestrator把分工自动化。与Hydrogen一起发布的Antigravity Orchestrator,不再”选一个模型从头跑到尾”,而是在同一会话内根据任务类型动态切换Carbon与Hydrogen。官方给出的实测是:在Terminal-Bench 4.0上,Orchestrator达到接近Carbon的任务成功率,但平均少用24%配额、快19%。搭建并行智能体时的推荐范式是——让Carbon当协调者负责决策与拆解,让Hydrogen当执行与验证的worker,在相互隔离的工作区里同时构建和测试。
第四步,做成本迁移与算账。执行层的调用量远大于推理层,单价必须压下来,智能体工作流的成本模型才成立。实操上,把大代码仓、长文档一次性交给Hydrogen做检索、修改与测试(百万token统一价、不加价),只在关键架构决策处调用Carbon。衡量口径也随之改变:从”单模型跑分”转向”组合后的单位任务成本”。
第五步,内容侧同步观察。Hydrogen接替3.8 Flash成为Google Search/AI Mode默认模型后,谷歌强调三点改进:对复杂多段问题的意图理解更准、能连接更多相关网站与链接、给出更多视觉化内容(结构化回答、对比表格、定制工具)。对做内容与GEO(生成式引擎优化)的团队,这意味着需要重新观察新模型更倾向引用哪类页面、结构化内容是否更受偏好——搜索结果正从”链接列表”变成”可用的答案组件”。
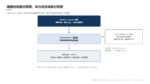
Orchestrator把”模型组合”变成默认体验,用户无需自己判断每一步该用哪个模型(数据来源:谷歌官方博客)。
边界与避坑
第一,别拿Hydrogen做终端与图形界面操作。官方基准表里,它在Terminal-Bench 4.1(57.0%对Claude Sonnet 5.5的63.9%)、OSWorld-2.1离线子集(77.6%对83.9%)、Terminal-Bench-Science 0.1(51.4%对59.9%)三项落后,这类计算机操作任务对手仍更强。第二,跨厂商基准不可直接相加或取平均:测试框架、提示词与评分方式均由发布方设定,同名基准在不同厂商的实现常有差异。第三,谷歌未披露Hydrogen的参数量、训练数据规模、训练算力与蒸馏细节,”快2.5倍””虚假陈述减少5倍以上””少用24%配额、快19%”等对比也均为自测口径。上线前,建议用自己的真实工程任务跑一轮对照,再决定Carbon与Hydrogen的切换阈值。
一句话方法论:前沿模型负责难题、执行模型负责吞吐、编排器负责在两者之间调度——谁先把这套”分层+编排”跑通,谁就能在同样的智能水平下,把每个任务的单位成本压得更低。
你现在的Agent工作流是”一个模型从头跑到尾”,还是已经开始按任务分层?评论区聊聊你最想把哪一类活儿交给执行模型。

