如果说用一个词语来概括今年的技术热点,那无疑是“智能体”(AI Agent)。AI发展越深,大家越发现边缘AI才是真正的大趋势。怎么才能把AI,下放到越来越多设备是边缘AI当下考虑的问题。
2026年11月18日,安谋科技举办Arm Cortex-M CPU新品说明会,重磅发布了全新的Cortex-M42内核,并正式推出基于该产品的“星辰100e”AIoT原型平台。
Cotex-M系列内核是大多数MCU的构成基石。其中,Cortex-M0、M3、M4和M33等经典内核,凭借低功耗、小面积和成熟的软件生态,在消费电子、工业控制等领域得到了广泛应用。但边缘AI正在逐渐下放至越来越多的低功耗设备中,市场上一直缺乏功耗又低、AI算力又强的MCU。
Cortex-M42的到来,正是为了填补这一空白。它在延续经典Cortex-M架构优势的同时,引入Helium向量计算能力,还可以搭配Ethos-U NPU,让过去受限于成本和功耗的主流MCU,也有机会运行更加复杂的AI算法。
一场围绕低成本端侧AI的竞争,已经开始了。
为什么需要Cortex-M42?
“随着AI向端侧迁移,越来越多的嵌入式设备开始承担音频处理、视觉识别、信号分析等复杂任务,部分传统DSP算法也逐渐由机器学习模型取代。然而,这些设备往往受到功耗、芯片面积和存储容量的严格限制。”Arm边缘AI产品管理高级总监Lionel Belnet如是说。
他举例说明,可穿戴设备需要尽可能延长续航,工业控制设备则必须在规定时间内完成数据采集、计算和控制输出。如何在有限资源下提高计算性能,成为MCU面临的新挑战。
为此,Arm推出开箱即用的Armv8.1-M架构支持的Cortex-M42,将Helium向量扩展引入更紧凑的处理器设计,在有限资源下提高DSP和AI计算效率。
说白了,不同设备对计算能力、功耗、成本和尺寸的要求差异很大,不可能通过单一解决方案满足所有需求。所以Arm希望通过覆盖不同性能等级的处理器产品组合,为合作伙伴提供适合不同应用的计算技术。
除此之外,更重要的是,Arm还想保持熟悉的Cortex-M架构,引入新的计算能力。
一致性一直是Cortex-M系列生态的重要优势。Arm持续提供相对完整的处理器IP,包括CPU、调试功能、计算加速技术以及相关系统组件。不同代际产品之间保持一定程度的一致性,使开发工具、软件库和工程经验能够得到复用。

看Cortex-M42的左右两端
通过M42这个数字,我们不难看出,这个内核是介于Cortex-M33/M4和Cortex-M52之间的一个内核。
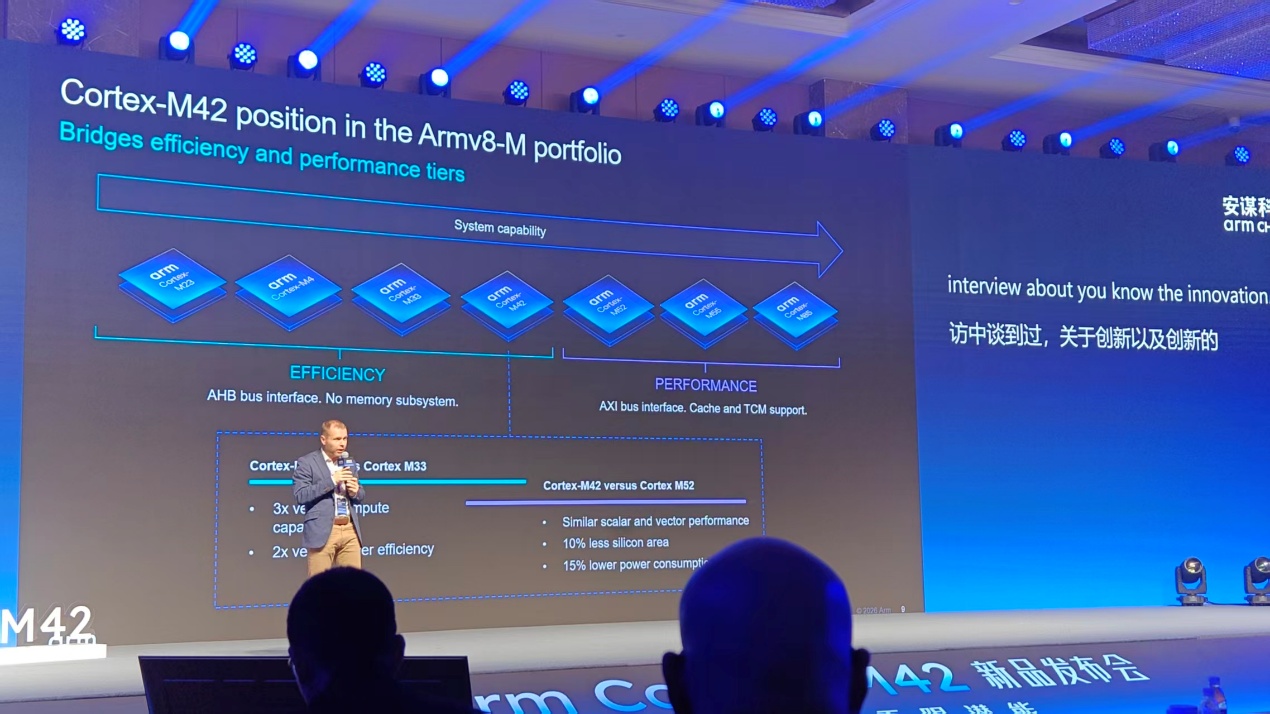
安谋科技CPU产品总监朱晓鸣向EEWorld介绍,Cortex-M4和Cortex-M33在向量计算性能存在一定局限,Cortex-M42采用Armv8.1-M架构,支持Helium向量扩展,能够提供数倍于传统Cortex-M4和Cortex-M33的向量计算性能;而相比Cortex-M52,Cortex-M42更加重视芯片面积、功耗和简单系统架构下的实现效率,适合存储资源有限、成本敏感的主流MCU应用。
不过,Cortex-M42的目标并不是替代现有Cortex-M4和Cortex-M33的全部市场。对于仍然以传统控制任务为主的应用,这些处理器依然具有价值。但当客户希望引入新的算法,或者现有处理器的计算性能已经达到瓶颈时,Cortex-M42可以在传统MCU基础上增加AI、DSP和向量计算能力。
有人可能会问,3年前Arm和安谋科技已经联合发布了Cortex-M52,Arm此前也发布过Cortex-M55,为什么还要发布这款产品?朱晓鸣解释,一个非常重要的原因是兼容性。处理器设计不能只考虑硬件IP,还需要考虑软件开发者和算法工程师的迁移成本。
他补充说道,对于现有Cortex-M4和Cortex-M33用户来说,迁移到Cortex-M42相对容易。它延续了经典Cortex-M处理器的集成方式,软件迁移工作量较小。如果迁移到Cortex-M55或Cortex-M85,开发者可能还需要针对新的存储子系统和总线架构进行调整。虽然这些工作能够完成,但开发周期和工程成本可能随之增加。因此,对于希望在现有产品基础上逐步引入AI和向量计算能力的客户,Cortex-M42是一种比较自然的升级选择。
详细解析值得关注的技术细节
第一是Armv8.1-M架构引入的Helium(M-Profile Vector Extension,MVE)向量扩展功能。Helium主要用于加速常见的DSP和机器学习计算。
Helium具有两个重要特点。首先,它采用128位定长向量,能够在一条指令中处理多个数据元素。其次,Helium提供150多条专用向量指令,覆盖多种DSP、数学和机器学习运算。这两项特性使其能够在适合单指令多数据(SIMD)处理的算法中获得明显的性能优势。
Arm已经在相关软件库中提供针对Helium优化的算法实现。开发者可以直接调用这些库,在不需要自行编写底层向量指令的情况下获得性能收益。例如,CMSIS-DSP提供FFT、滤波、矩阵计算等DSP函数,CMSIS-NN则面向神经网络运算提供优化实现。通过这些软件库,Cortex-M42可以加速音频处理、传感器数据分析和机器学习推理等任务。
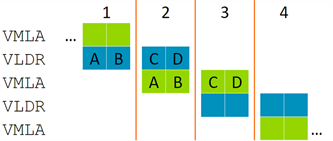
MVE中的按节奏执行
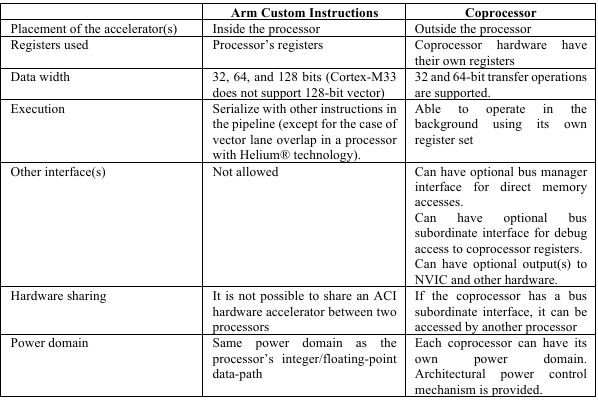
第二是自定义指令ACI(Arm Custom Instructions)。ACI允许芯片设计合作伙伴针对特定应用,在CPU内部增加专用计算功能,将部分运算直接集成到处理器执行流水线中。ACI主要针对特定运算进行加速,和Helium叠加使用可以进一步增强性能。
对于某些具有固定算法需求的芯片厂商来说,这提供了额外的优化空间。例如,合作伙伴可以针对特定数学运算、DSP算法或应用中的高频计算操作设计专用指令,以改善执行效率。这种方式能够在通用CPU架构基础上实现一定程度的硬件差异化。
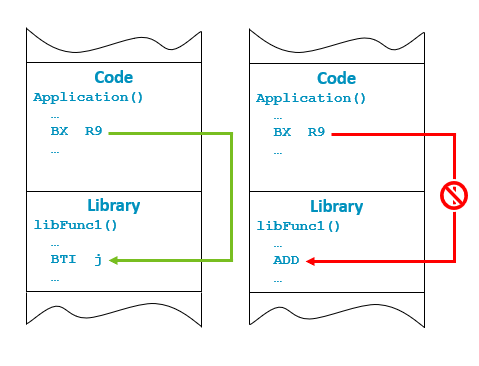
第三是分支目标标识BTI(Branch Target Identification)技术。BTI是一种控制流安全机制,可以帮助系统防御部分利用间接分支进行的控制流劫持攻击。相关安全能力能够得到编译器和软件工具链的支持,从而降低开发者采用这些机制的难度。
对于工业、消费和企业级嵌入式设备来说,安全功能正在成为处理器选型的重要因素。随着设备连接能力增强、软件复杂度提高,处理器需要在有限资源下提供更多硬件安全支持。
BTI已获得编译器和软件工具支持,开发者可通过重新编译并启用相关保护机制,以较低的软件改造成本提升安全性。不过,BTI只能防御特定类型的攻击,仍需配合其他安全措施。
第四是兼容性。Cortex-M42延续了经典Cortex-M的集成方式,并针对AHB总线系统进行优化。现有Cortex-M4和Cortex-M33用户可以较容易地迁移到Cortex-M42,在复用原有软件的同时获得更强的向量计算能力。
直接上Cortex-M42性能测试数据
芯片行业一直有句老话:“Talk is cheap, show me the chip.”那么,Cortex-M42的实际性能究竟有多强?直接看看测试数据。
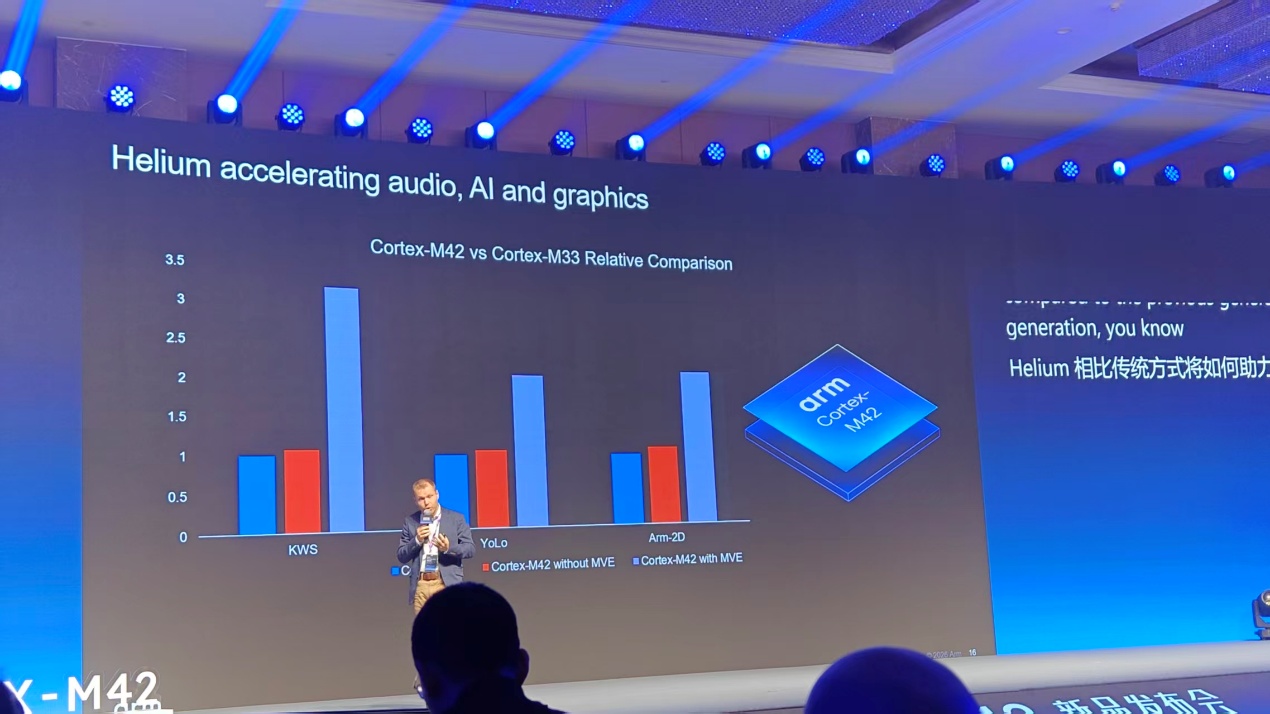
Lionel Belnet公布了一组数据,相比Cortex-M33,Cortex-M42的部分向量计算性能最高提升约3倍,执行相同向量任务的能效最高提升约2倍, 标量计算性能提升5%,机器学习性能提升超过5倍, DSP性能提升超过2.5倍,。
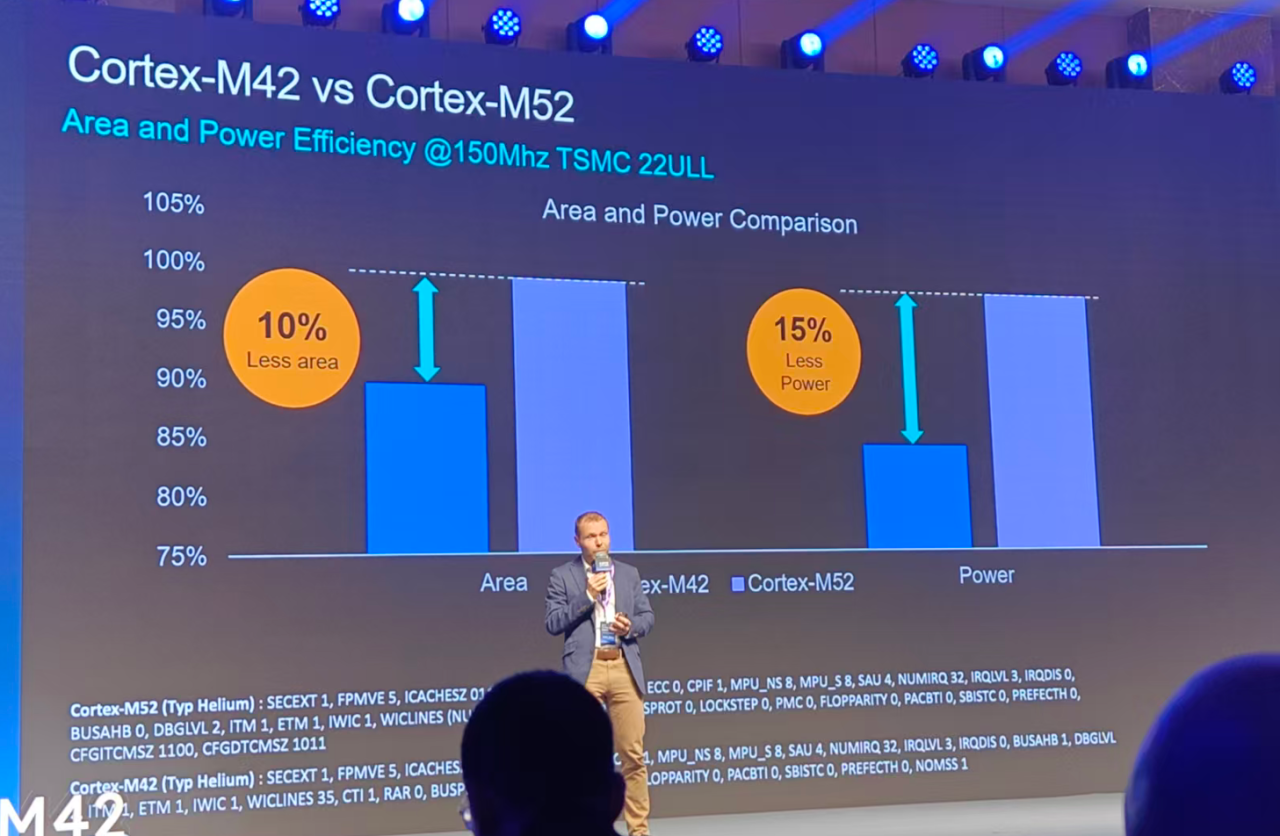
在芯片面积和功耗方面,Cortex-M42相比Cortex-M52也有所改善。根据Arm公布的测试数据,在采用台积电22ULL工艺、运行频率为150MHz的条件下,Cortex-M42的芯片面积比Cortex-M52减少约10%,功耗降低约15%。
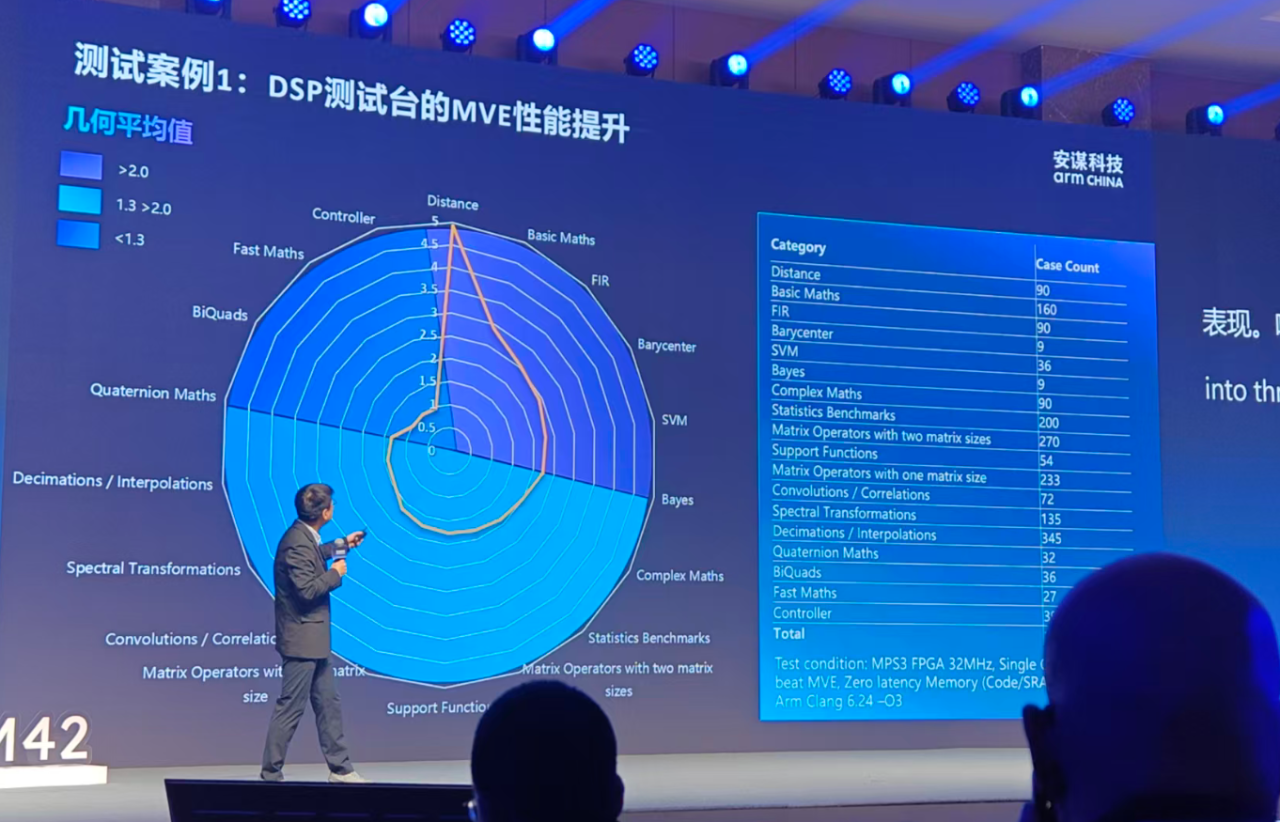
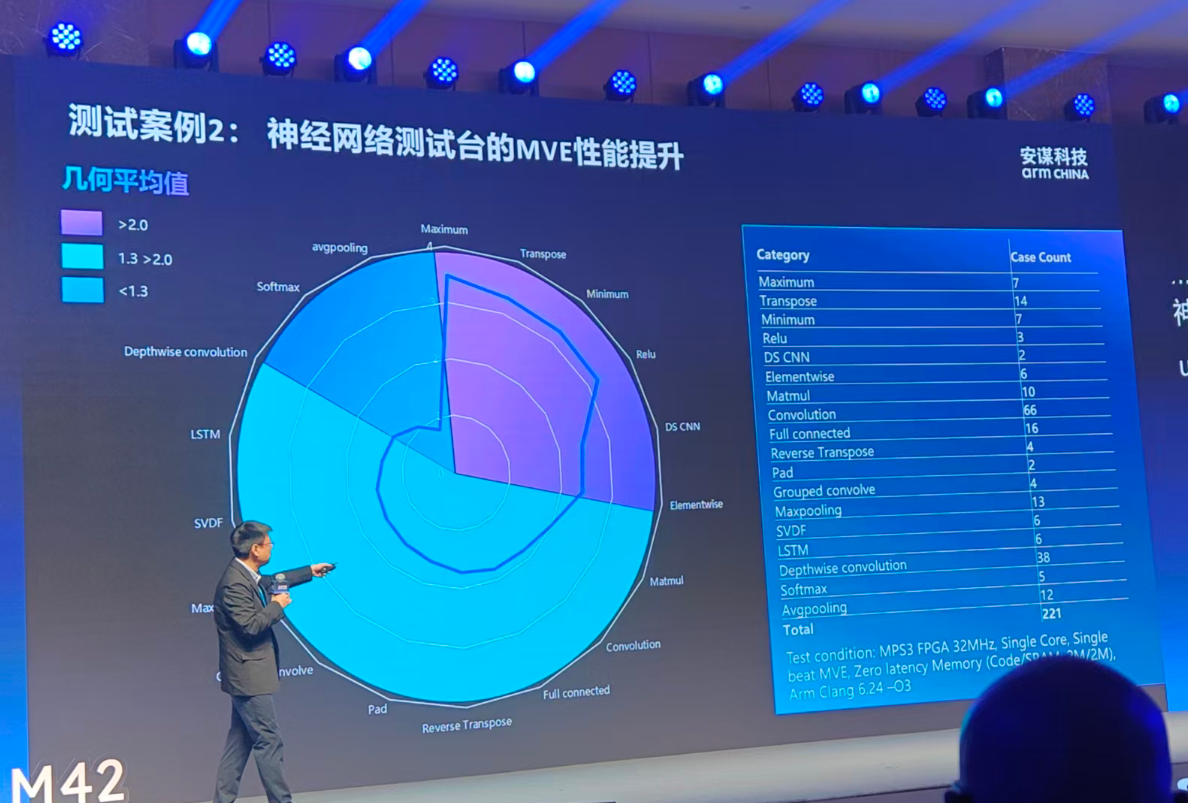
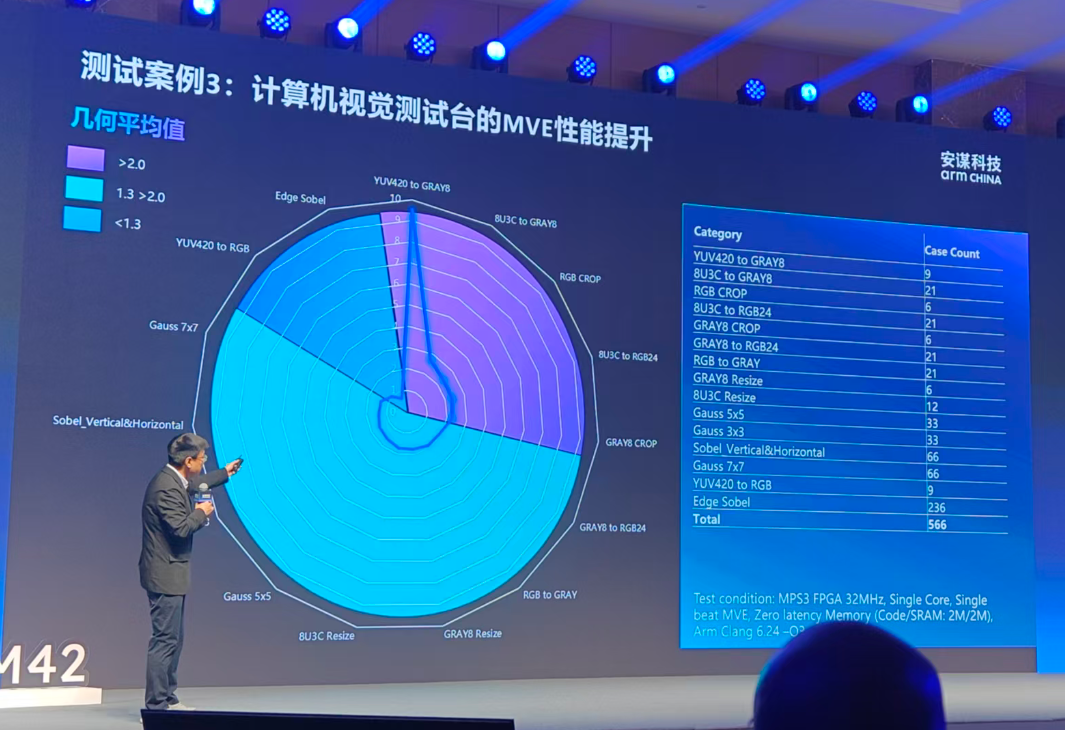
朱晓鸣则选取了DSP、神经网络和计算机视觉三个测试集,比较启用Helium与未启用Helium时的性能差异。测试结果被划分为三个区间:性能提升超过2倍的优势区,提升1.3至2倍的增强区,以及提升低于1.3倍的平衡区。
之所以将1.3倍作为重要分界线,是因为增加MVE硬件模块会带来一定的芯片面积开销。按照安谋科技的评估,相比标量处理器配置,增加MVE模块可能使相关CPU实现面积增加约30%。因此,如果性能提升超过1.3倍,在这一简化比较下,通常意味着单位面积能够获得更高的计算性能。
在DSP测试中,安谋科技团队执行了近2000个测试用例。结果显示,Helium对FIR滤波、向量距离计算等数据并行度较高的算法加速效果明显,对卷积、矩阵乘法等运算也有一定提升。相比之下,部分级联滤波、三角函数、平方根和幂函数等运算,由于数据并行度有限,加速效果相对较弱。针对这些任务,可以通过ACI自定义指令进一步优化。
在221多个神经网络测试用例中,Helium对全连接层、深度卷积和ReLU激活函数等算子表现较好,部分测试的性能提升超过3倍。但对于Softmax等涉及指数、归约和归一化的运算,向量化收益相对有限。安谋科技认为,这类算法可以通过ACI进行专项优化,而计算密集型神经网络任务还可以采用Ethos-U NPU进一步加速。
在566个计算机视觉测试用例中,Helium对像素格式转换表现突出。例如,特定YUV420格式转换为8位灰度图像的性能提升约10倍,高斯滤波等算法也有一定改善。不过,部分边缘检测和复杂格式转换任务难以充分向量化,加速效果相对有限。
把Cortex-M和Ethos进行结合:“星辰100e”诞生了
从朱晓鸣的测试中,我们可以看出,Helium适合数据并行计算,ACI适合特定算法的专项优化,而NPU则更适合计算密集型神经网络任务。如果把三个技术都容易补充在一起,就能满足不同嵌入式应用的计算需求。
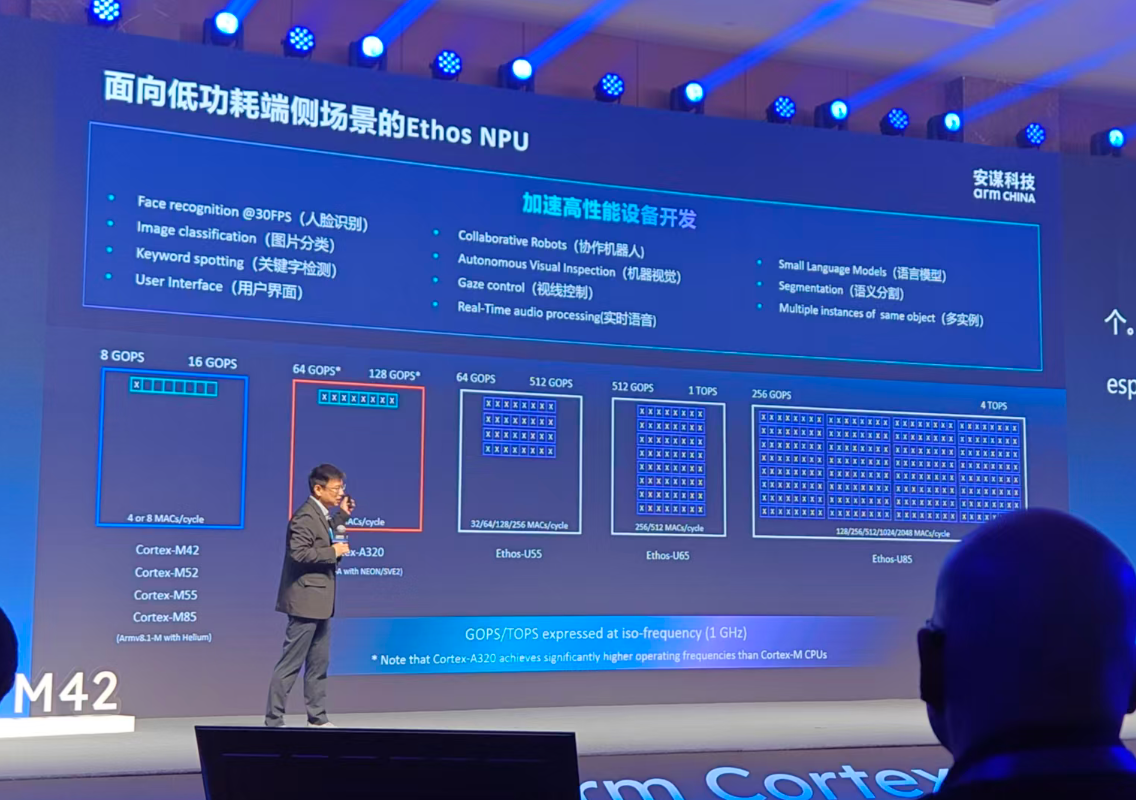
因此在完成Cortex-M42向量性能测试后,安谋科技进一步将其与Ethos-U55 NPU结合,开发了“星辰100e”原型平台。此处的“e” 最初代表Experiment(实验),因为团队尚不确定增加NPU后的性能收益和面积开销。随着测试结果超出预期,“e”也被重新解释为Enhancement(增强)。
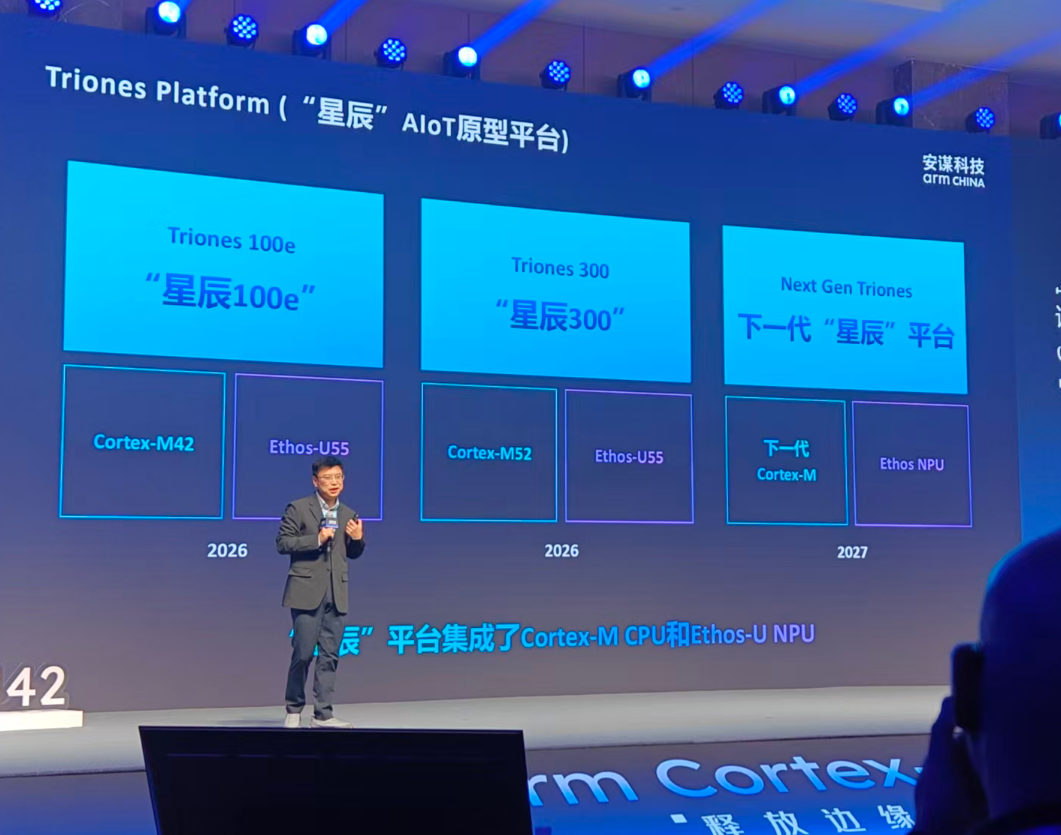
对于总线选择,安谋科技朱晓明解释,AXI具有更高的数据吞吐能力,适合Ethos-U NPU等带宽需求较高的AI计算单元;AHB则架构更简单,访问延迟和实时响应更容易预测,因此广泛用于传统MCU。
在Cortex-M42与Ethos-U55组合中,安谋科技通过协议转换桥连接AHB和AXI总线。虽然转换会带来一定性能开销,但测试表明,当主要AI计算由NPU承担时,这部分损失可以接受,从而兼顾CPU的实时性与NPU的高带宽需求。
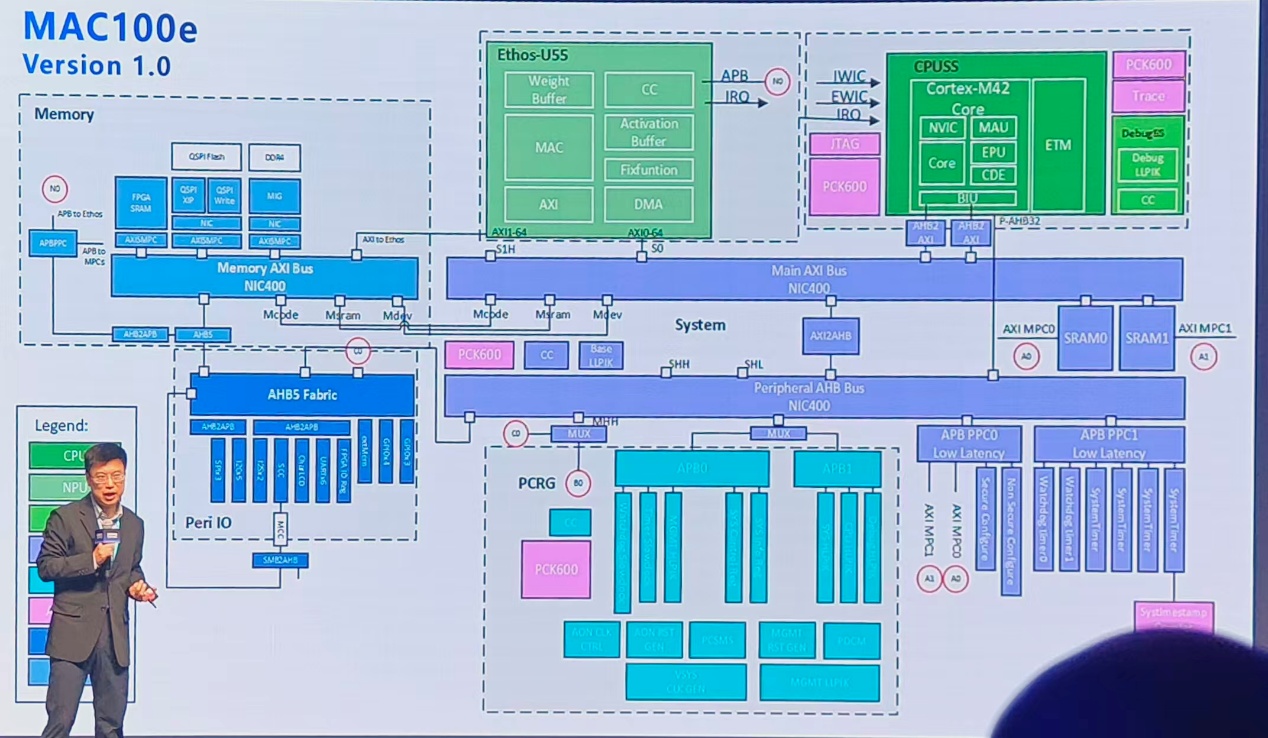
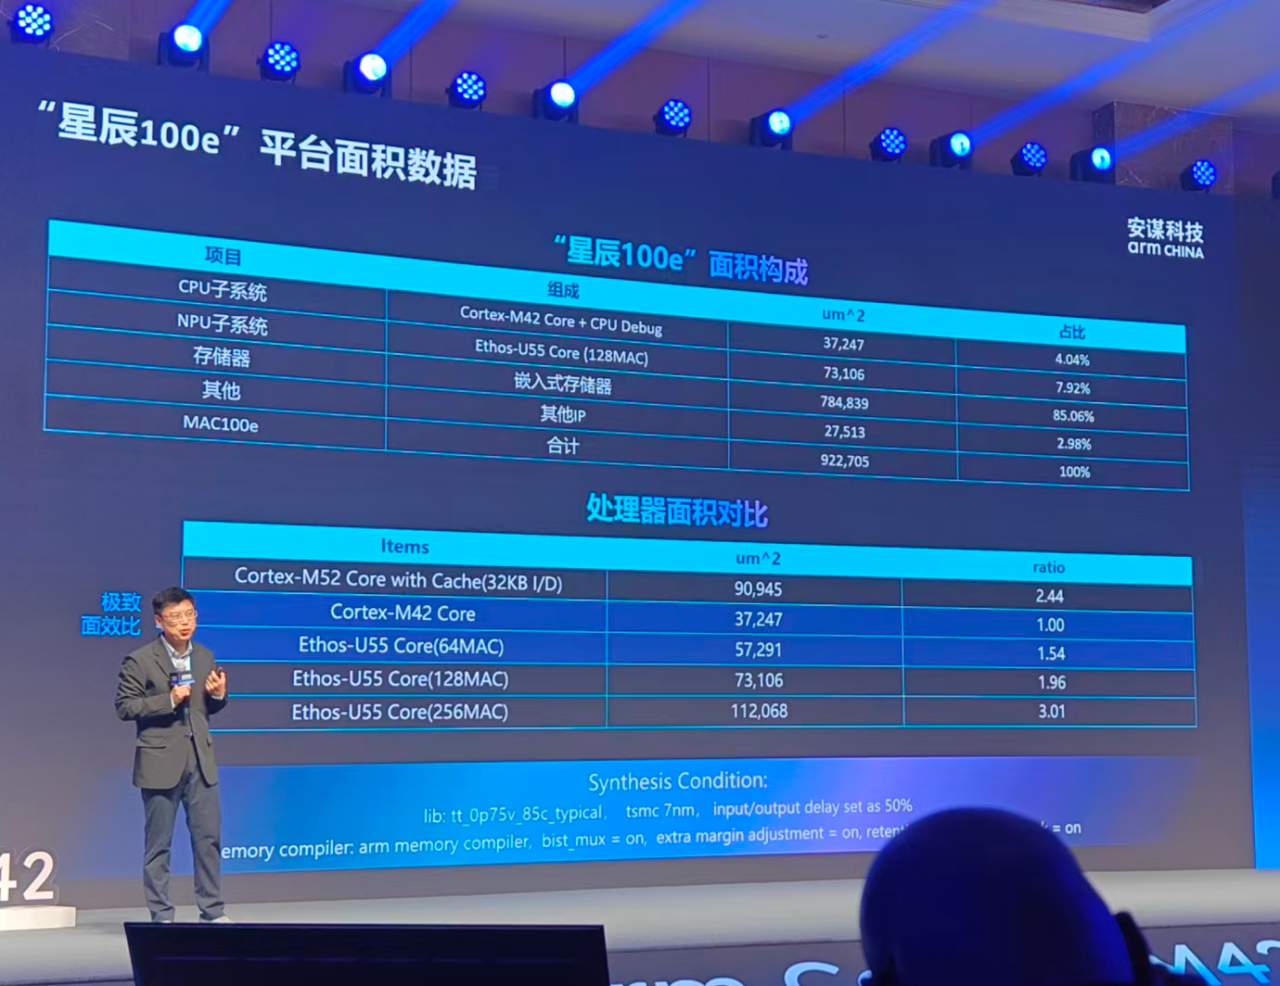
安谋科技的面积评估发现,增加NPU未必会大幅增加芯片面积。
以Cortex-M42的CPU面积为1.0,Cortex-M52约为1.1;如果为Cortex-M52配置32KB指令缓存和32KB数据缓存,等效面积将增加至2.44。相比之下,64 MAC配置的Ethos-U55面积约为1.54,与Cortex-M42组合后的总面积约为2.54。
这意味着,在特定工艺和配置下,Cortex-M42加Ethos-U55的面积,与配置64KB缓存的Cortex-M52系统相近,但Cortex-M42却能够通过专用NPU获得更强的AI推理能力。
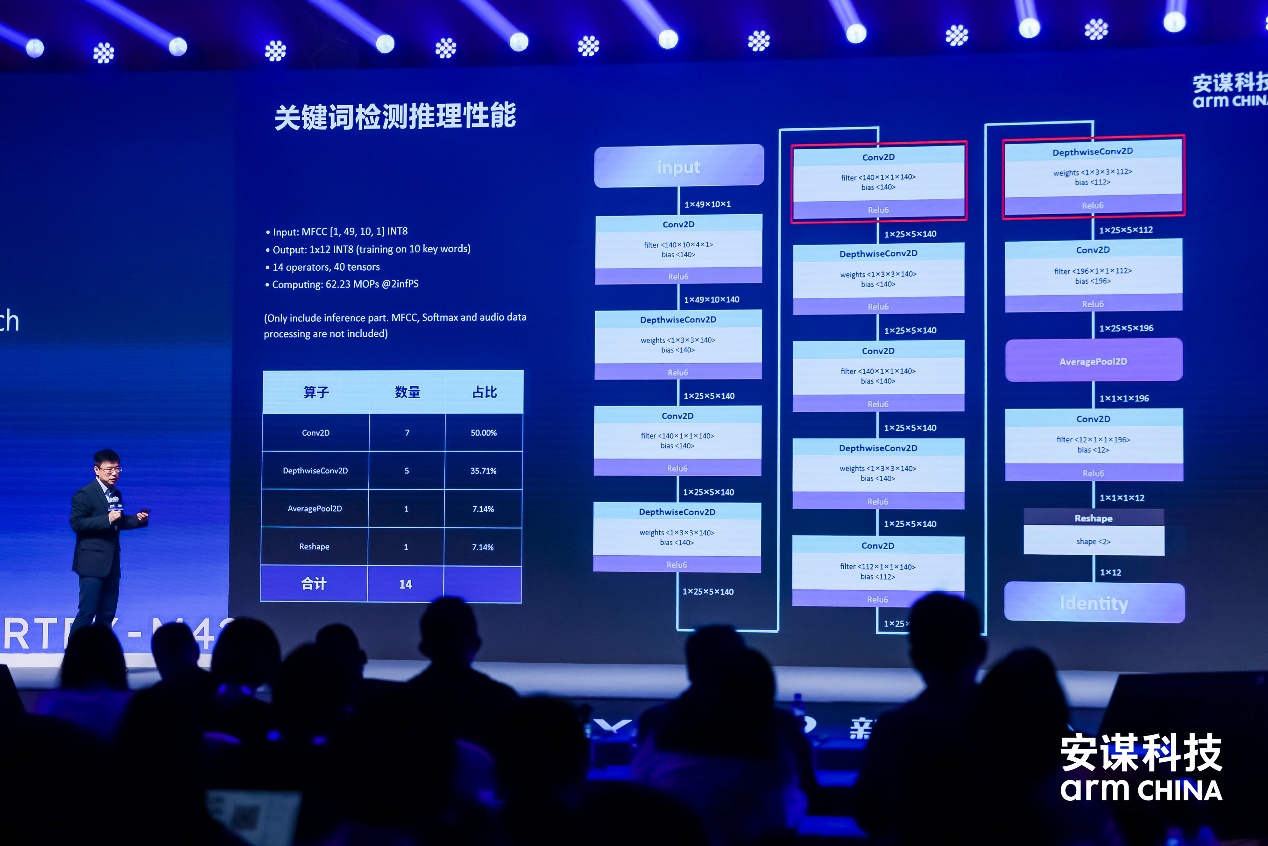
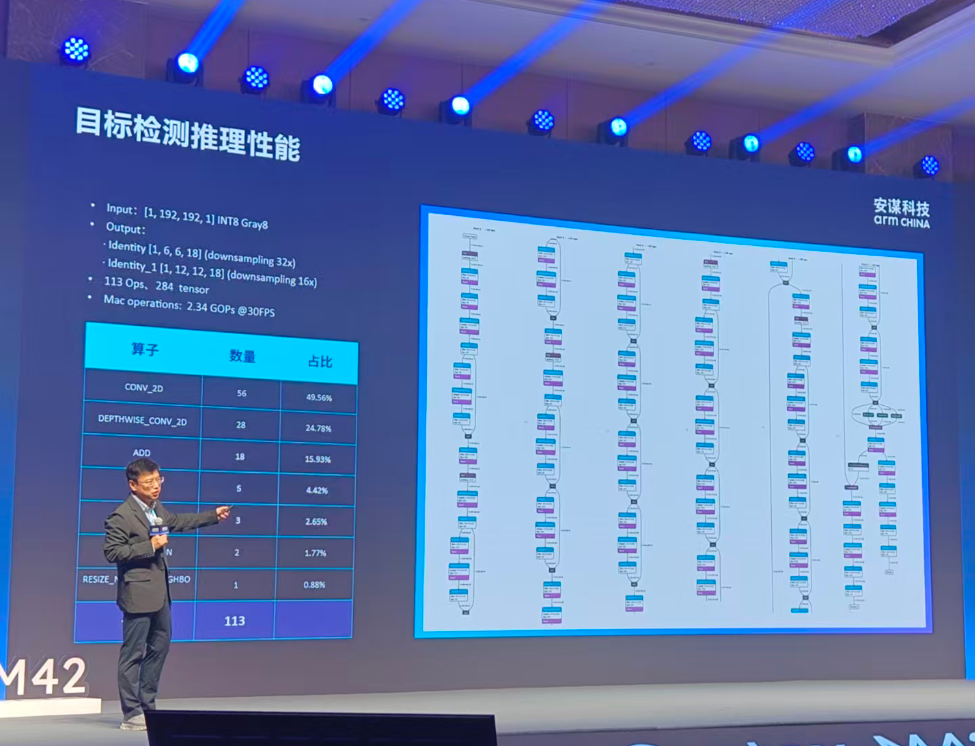
安谋科技在星辰100e平台上测试了关键词检测(KWS)、目标检测和自动语音识别(ASR)三个典型AI应用,以Cortex-M42单独运行模型的性能作为基准。
在关键词检测中,模型计算量约62.23 MOPS,配置缓存的Cortex-M52性能约为Cortex-M42的2.7倍。加入Ethos-U55后,性能进一步提升,且Cortex-M42与Cortex-M52搭配NPU的表现接近。
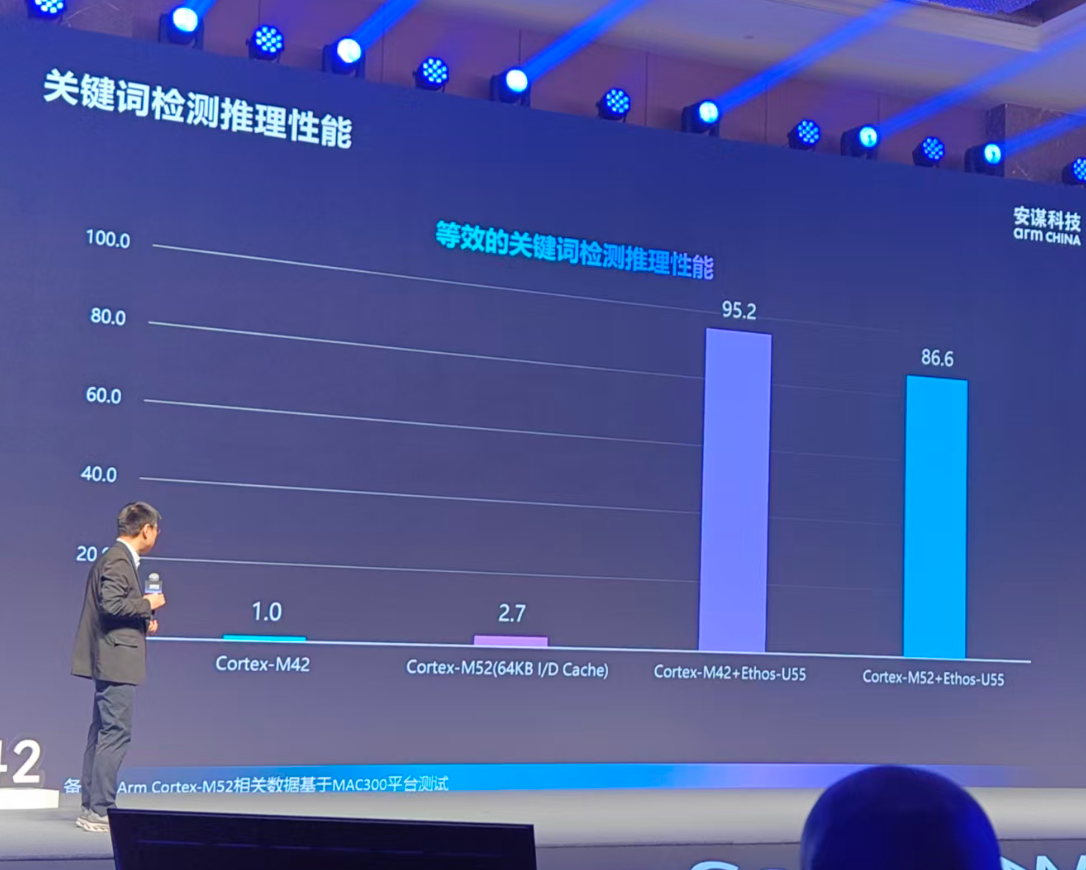
在目标检测中,模型计算量约2.34 GOPS,Cortex-M52性能约为Cortex-M42的2.3倍。加入NPU后,推理性能获得数十倍乃至百倍量级的提升。
在自动语音识别中,模型计算量约3.49 GOPS,Cortex-M52性能约为Cortex-M42的5.8倍,而加入Ethos-U55后,部分测试的加速幅度达到约300倍。
测试表明,对于计算密集型AI任务,专用NPU能够带来远高于CPU单独执行的性能提升。而当NPU承担主要计算任务时,Cortex-M42与Cortex-M52之间的性能差距也明显缩小。
通过这些测试,可以看出来运行在星辰100e上的Cortex-M42加Ethos-U55,星辰300的Cortex-M52加Ethos-U55测试的推理数据都高。朱晓鸣解释,两者在系统架构、缓存等配置方面存在差异。因此,个别测试中Cortex-M42表现更好,并不意味着其整体性能优于Cortex-M52。
朱晓明强调,Cortex-M42并非要取代Cortex-M52、Cortex-M55或Cortex-M85。对于需要大量通用计算、复杂软件和控制任务的应用,更高性能的Cortex-M处理器仍具有优势。而对于能够明确划分CPU与NPU任务、更加重视面积和能效的AI MCU,Cortex-M42加Ethos-U55可能是更合适的选择。
Cortex-M42能够改变哪些行业?
Lionel Belnet表示,可穿戴设备是当前较为活跃的应用方向之一。智能手表、智能眼镜以及其他可穿戴设备通常受到电池容量、芯片面积和散热能力的限制,却需要持续执行传感器数据处理、语音识别、运动检测和其他智能功能。Cortex-M42能够在较低功耗下提供DSP和AI计算能力,因此适合这类应用。
另一个值得关注的方向是低功耗常开计算子系统。例如,在智能眼镜中,系统可能包含负责复杂视觉处理和AI推理的高性能处理器,但这些处理器不适合始终保持运行状态。此时,可以使用Cortex-M42构建低功耗常开子系统,持续监测环境和传感器输入。当检测到特定事件时,再唤醒高性能计算部分。这种设计能够减少系统整体能耗,延长电池续航时间。
此外,Cortex-M42还可以用于连接设备、工业控制、消费电子、智慧城市和智能建筑等领域。虽然Cortex-M42重点强调AI计算能力,但Helium同样是一项DSP加速技术,因此它的应用并不局限于AI推理。传统音频处理、传感器信号处理、数字滤波和控制算法,同样可以利用Helium获得性能改善。
在介绍中,除了产品技术,Arm还介绍了Cortex-M42的商业授权方式。目前,Cortex-M42已纳入Arm Flexible Access和Total Access两项计划。其中,Flexible Access允许合作伙伴访问多种Arm IP,开展技术评估、产品设计和原型开发,降低前期研发成本。目前,该计划已有全球超过300家合作伙伴采用,其中中国合作伙伴约90家。
Total Access则面向需要更广泛IP使用权限和技术支持的客户。Arm希望通过灵活的授权模式,帮助芯片厂商根据不同应用需求选择合适的处理器IP,加快产品开发。
文章来自:电子工程世界

