一、为什么这篇值得现在读
Google在2026年11月12日发布了新一代高速代理模型Gemini 4 Hydrogen,官方定位是”快且高效”的日常编码和Agent工作流模型。发布不到一周,它已经在Arena平台2026年第46周综合榜上以1497分位列第9名(±CI 4分,票数62675),在前端开发榜以1704分位列第10名,同时被集成到Google Search、Gemini App、AI Studio与Antigravity编排器中,面向免费用户开放。
对开发者来说,更实用的一件事是:按照Google AI Studio官方文档,gemini-4-hydrogen在Gemini API的免费层和付费层都能调用,GenerateContent和Interactions两套接口都支持。这意味着你现在就可以不花一分钱,把一个百万Token上下文、支持Agent工具调用、思考档位可调的高性能模型接进自己的项目。
本文按”领Key—最小调用—档位选择—长输出—从3.8 Flash迁移—Agent工作流示例—成本控制”七步展开,所有代码片段来自Google AI Studio官方Quickstart与社区已验证的迁移实践,读者可以直接复制到自己的项目里跑通。
二、第一步:3分钟领Key、装SDK
领Key的路径非常简单。打开浏览器访问aistudio.google.com/apikey,登录任意Google账号,点击”Get API key”创建密钥。新用户会被自动生成一个Google Cloud项目并绑定密钥,无需手动创建工程。免费额度按项目计算,如果同一个账号下有多个Key,共享同一份限速配额,可以在AI Studio控制台实时查看当前用量。
拿到Key之后,安装Google官方新一代Python SDK google-genai:
pip install -U google-genai
export GEMINI_API_KEY=”你的key”
Windows用户在PowerShell里换成:
$env:GEMINI_API_KEY=”你的key”
这里要特别提醒一个常见坑:google-genai和早期的google-generativeai是两个不同的包,前者是2025年之后的新版SDK,后者已经停止主要功能更新。网上很多老教程里的import google.generativeai as genai写法在Hydrogen上会报模型不识别错误,务必换成from google import genai。
三、第二步:最小可运行调用(Interactions API)
官方Quickstart推荐的是Interactions API,它相比传统的GenerateContent接口多了一层”会话状态管理”,对Agent工作流更友好。默认思考档位是high,单次同步输出上限65,536 Token。
from google import genai
client = genai.Client() # 自动读取环境变量 GEMINI_API_KEY
interaction = client.interactions.create(
model=”gemini-4-hydrogen”,
input=”用 Python 写一个令牌桶限流器,并给出单元测试。”
)
print(interaction.output_text)
不想装SDK,也可以直接走REST接口。下面这段curl可以在任何终端里跑通:
curl “https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent”
-H “x-goog-api-key: $GEMINI_API_KEY”
-H “Content-Type: application/json”
-d ‘{“contents”:[{“parts”:[{“text”:”用一句话解释什么是令牌桶限流”}]}]}’
跑通这一步,你就完成了从”注册”到”调用”的全链路验证。接下来的重点是怎么把这个模型用对、用省。
四、第三步:选对思考档位,这是省钱的关键
Gemini 4 Hydrogen提供四档思考等级:low、medium、high(默认)和新增的xhigh。档位越高,模型内部推理链越长,输出质量和复杂任务成功率越高,但延迟和Token消耗也越大。
官方给出的选择原则很直白:复杂任务先用high,只有high搞不定的多步骤编码或Agent难题再上xhigh;xhigh在简单问题上可能”想太多”,反而增加延迟和成本。
interaction = client.interactions.create(
model=”gemini-4-hydrogen”,
input=”审查这段支付重试队列代码的竞态条件,并重写加锁逻辑。”,
generation_config={“thinking_level”: “xhigh”}
)
一个务实的做法是:在你自己的评测集上,四档都跑一遍(把max_output_tokens设大一点,避免截断),然后选能够达标的最低档。这样既保证了效果,又不会为不必要的推理深度买单。
下表是社区实测的四档在典型任务上的表现参考(数据来自掘金、CSDN多位开发者的公开评测,非Google官方口径,实际效果与任务复杂度、Prompt质量强相关):
思考档位 | 适用场景 | 相对延迟 | Token消耗参考
low | 简单问答、格式转换、短文本生成 | 最快 | 最低
medium | 常规编码、多轮对话、简单Agent | 较快 | 中等
high(默认) | 复杂编码、代码审查、多步推理 | 较慢 | 较高
xhigh | 数学证明、系统架构设计、深度Agent规划 | 最慢 | 最高
五、第四步:超长输出用后台执行
Hydrogen的输入、思考、输出共用一个1,048,576 Token的窗口,单次同步请求最多输出65,536 Token。如果你要生成更长的内容——比如一整份技术文档、一个完整模块的代码——需要开启后台执行模式。
interaction = client.interactions.create(
model=”gemini-4-hydrogen”,
input=”写一份完整的FastAPI+PostgreSQL项目脚手架,包含用户模块、权限模块、日志模块、测试用例。”,
max_output_tokens=200000,
background=True
)
轮询获取结果
while interaction.status != “completed”:
time.sleep(5)
interaction = client.interactions.get(id=interaction.id)
print(interaction.output_text)
这里有一个官方文档里明确写过、但很多教程漏掉的细节:只开background=True而不设max_output_tokens,服务端会在65,536 Token处停下。必须同时把max_output_tokens设到65,536以上,后台模式才会按64K一跳继续生成。
六、第五步:从Gemini 3.8 Flash迁移的六个坑
很多读者的现有项目正在用gemini-3.8-flash,想升级到Hydrogen。官方迁移清单加上社区实践,总结成六个必改点:
改模型ID:gemini-3.8-flash → gemini-4-hydrogen,注意不要写成gemini-4-hydrogen-high之类的别名,官方Model ID就是这一个。
去掉过低的输出上限:3.8 Flash时代很多项目把max_output_tokens写成8192甚至4096,Hydrogen的推理链更长,这个上限会被思考Token吃掉一大半,建议至少提到32768。
思考档位显式声明:3.8 Flash没有thinking_level参数,迁移后如果不显式设置,默认走high,可能导致原本跑得动的简单任务突然变慢。建议在Agent入口统一配置,按任务类型分档。
工具调用Schema兼容:Hydrogen的Function Calling返回结构与3.8 Flash基本兼容,但对parameters字段的JSON Schema校验更严格,老代码里如果有type: “any”或缺失required的写法,会直接报400错误。
多模态输入的MIME类型:Hydrogen对图像、音频、视频的MIME类型识别更精细,老代码里用image/*通配的写法建议改成具体的image/png、image/jpeg。
缓存命中的定价差异:Hydrogen的缓存命中价格与3.8 Flash不同,如果你的项目重度依赖Prompt缓存,重新核算成本模型。付费层每百万Token输入1.5美元、输出7.5美元;缓存命中价格以Google AI Studio控制台实时显示为准。
从Gemini 3.8 Flash迁移到Gemini 4 Hydrogen的六个关键改动,整理自Google AI Studio官方迁移文档与社区实践。
七、第六步:一个完整的Agent工作流示例
下面这段代码把前面所有要点串成一个最小可运行的Agent工作流:读取本地Markdown文档、调用工具搜索、生成长输出报告。
from google import genai
import time
client = genai.Client()
定义工具Schema
tools = [{
“function_declarations”: [{
“name”: “search_docs”,
“description”: “在本地文档库中搜索关键词”,
“parameters”: {
“type”: “object”,
“properties”: {
“query”: {“type”: “string”, “description”: “搜索关键词”},
“top_k”: {“type”: “integer”, “description”: “返回条数”}
},
“required”: [“query”]
}
}]
}]
第一步:发起Agent任务
interaction = client.interactions.create(
model=”gemini-4-hydrogen”,
input=”阅读项目README.md,总结架构设计,并输出一份不少于3000字的技术评审报告。”,
tools=tools,
generation_config={“thinking_level”: “high”},
max_output_tokens=100000,
background=True
)
第二步:轮询直到完成
while interaction.status != “completed”:
time.sleep(5)
interaction = client.interactions.get(id=interaction.id)
如果模型请求工具调用,在这里执行并回传结果
if interaction.status == “requires_action”:
tool_result = execute_local_tool(interaction.required_action)
interaction = client.interactions.submit_tool_outputs(
id=interaction.id,
tool_outputs=tool_result
)
print(interaction.output_text)
这段代码展示了Hydrogen在Agent场景下的三个核心能力:工具调用、长输出、后台执行。实际项目里,你还需要加上错误重试、超时控制、日志记录,但骨架就是这么多。
八、第七步:成本控制与免费层使用建议
免费层的额度按项目计算,多Key共享。对个人开发者跑Agent测试、学习实验来说完全够用,但要注意三点:
第一,免费层有RPM(每分钟请求数)和TPM(每分钟Token数)双重限速,具体数值以AI Studio控制台实时显示为准。如果你的Agent是并发调用,很容易撞上限速,建议加一个令牌桶做客户端限流。
第二,思考档位是成本的最大变量。同一个任务,xhigh档的Token消耗可能是low档的5-10倍。在开发阶段用high档调通逻辑,上线后按任务类型分档,是最经济的做法。
第三,后台执行模式虽然能生成长输出,但计费按实际生成Token计算,不会因为走后台就打折。如果任务可以拆成多个短请求并行,总成本可能比一个长请求更低。
Gemini 4 Hydrogen四档思考(low/medium/high/xhigh)的相对Token消耗梯度与适用场景,档位口径来自Google AI Studio文档,倍数为社区实测区间。
九、Hydrogen在整个Gemini 4家族里的位置
Google目前的Gemini 4家族有三个主力型号,定位各不相同:
Gemini 4 Carbon:旗舰推理模型,Arena综合榜第1名(1526分),适合最复杂的推理、科研、架构设计任务,价格每百万Token输入2美元、输出10美元。
Gemini 4 Argon:与Carbon同家族,综合榜第2名(1522分),支持1M上下文,价格与Carbon相同,在机器人研发、数字孪生场景有专门优化。
Gemini 4 Hydrogen:效率执行层,综合榜第9名(1497分),价格每百万Token输入1.5美元、输出7.5美元,速度比Carbon快约2.5倍,面向日常编码、Agent工作流与消费级应用。
Google在Antigravity编排器里做了一个很聪明的设计:同一个任务中,系统会按进展自动在Carbon和Hydrogen之间切换。内部测试显示,这种编排方式在Terminal-Bench 4.0上接近Carbon单独使用的成功率,但平均减少24%的配额消耗、速度提升19%。对开发者来说,如果你的Agent框架支持多模型编排,把Hydrogen作为默认执行层、Carbon作为兜底推理层,是性价比最高的组合。
十、常见问题速查
Q1:免费层能用多久?会不会突然收紧?
A:Google没有公布免费层的明确截止日期。参考Gemini 3.8 Flash的历史,免费层通常会在新模型发布后维持至少一个季度,之后可能调整额度。建议趁早把项目跑通,同时做好切换到付费层的预案。
Q2:Hydrogen支持中文吗?效果如何?
A:支持。Hydrogen在中文编码、中文长文本生成上的表现与英文接近,但思考链内部仍以英文为主,对极专业的中文术语(如法律、医学)建议在Prompt里给出明确定义。
Q3:能不能用在生产环境?
A:可以,但要注意三点:一是免费层不保证SLA,生产环境必须走付费层;二是思考档位要在生产前锁定,避免自动升级导致成本失控;三是后台执行模式的轮询逻辑要做好超时和异常处理。
Q4:和Claude Sonnet 5.5、GPT-6.1 Sol怎么选?
A:如果你重度依赖Google生态(Google Cloud、Firebase、Workspace),Hydrogen是首选;如果任务以复杂编码和Agent为主,Claude Sonnet 5.5在前端开发榜以1772分位列第3,仍有优势;如果任务需要与OpenAI生态深度集成,GPT-6.1 Sol更合适。三者在价格上处于同一区间,选择更多取决于生态绑定而非绝对性能。
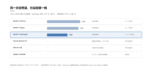
Gemini 4 Hydrogen与同价位竞品在Arena两个核心榜单上的表现对比,数据来自Arena平台2026年第46周公开榜单。
互动提问:你现在的项目里,Agent工作流的默认模型是哪一个?如果换成Gemini 4 Hydrogen,你最担心的是限速、成本还是效果?欢迎在评论区分享你的实测体验。

