2026年11月16日,阿里通义千问发布Qwen4系列首款旗舰模型Qwen4-Max(11月11日曾上线限时预览版,五天后转正式)。它主打三件事:全新稀疏MoE架构、原生视觉理解、100万token上下文窗口。对开发者更实在的一点是,模型已在千问AI平台开放API,阿里云百炼提供免费100万tokens试用额度,且兼容OpenAI与Anthropic的API格式——这意味着现有代码改几行就能迁过来。本文按”跑通—用对—算账”三步,给出一份可直接照做的上手指南。
一、先搞清楚它是什么
据阿里官方与新华财经等报道,Qwen4-Max总参数2.4万亿(2.4T),但每个token只激活约710亿(71B)参数,另有3280亿(328B)N-gram Embedding参数。激活参数比上代同规模少约25%,这正是”参数没涨、成本降一半”的来源。
架构上它动了三处:注意力层每四层里三层用Gated DeltaNet把历史信息压成固定状态、剩一层用Qwen稀疏注意力(QSA)按block粒度挑相关上下文,从而压低长序列开销;残差层用Gated Residual把残差流扩成四条并行分支;嵌入层用N-gram Embedding以较低算力换容量。这些是厂商披露的设计说明,普通使用者不必深究,但能解释一个现象:它把省下的算力花在了长上下文与token效率上,而不是榜单排名。
能力口径上,官方称Work360综合评测得分从上代47.74提升到52.69(提升超10%);全球前端编程盲测CodeArena排第6;在Agents’ Last Exam、Vals Index等第三方智能体评测中处于领先梯队。需要注意,Work360是阿里自建、覆盖721个细分领域的行业基准,属厂商自选口径。
二、五分钟跑通第一个API调用
第一步,在阿里云百炼控制台开通模型服务并创建API Key(新用户通常有免费额度,Qwen4-Max提供100万tokens试用)。第二步,把Key写进环境变量,避免硬编码。第三步,用OpenAI兼容模式调用,model填qwen4-max。
import os
from openai import OpenAI
client = OpenAI(
api_key=os.getenv(“DASHSCOPE_API_KEY”),
base_url 以百炼控制台”API参考”页给出的OpenAI兼容地址为准
base_url=”https://dashscope.aliyuncs.com/compatible-mode/v1″,
)
completion = client.chat.completions.create(
model=”qwen4-max”,
messages=[{“role”: “user”, “content”: “用三句话解释稀疏MoE为什么能省算力”}],
extra_body={“enable_thinking”: True}, # 开启深度思考
stream=True,
)
for chunk in completion:
if not chunk.choices:
continue
delta = chunk.choices[0].delta
if getattr(delta, “reasoning_content”, None):
print(delta.reasoning_content, end=””, flush=True) # 思考过程
if delta.content:
print(delta.content, end=””, flush=True) # 正式回复
跑通后先做一件事:把同一批真实任务分别用旧模型和qwen4-max各跑一遍,记录通过率与账单,再决定是否切默认路由。接口返回200不等于任务完成。
三、把100万上下文和缓存价一起用对
Qwen4-Max的两个卖点是长上下文与低缓存价,但都要”用对”才省钱。
长上下文别一次塞满。 支持100万token不等于中间信息都能被准确调用。处理长文档或整个代码库时,建议先分块做要点抽取,再把抽取结果拼进最终提示,比一股脑塞满更稳、也更便宜。是否”用满”要靠自己的任务集验证。
吃满缓存命中价。 据阿里云百炼定价页,Qwen4-Max国内输入¥10/百万token、输出¥30/百万token,缓存命中输入低至¥0.5/百万token(降幅约70%)。Agent类任务上下文重复率极高——同一份代码库、同一批文档反复读几十遍,缓存价一降,成本结构就变了。做法与OpenAI一致:保持系统提示与长上下文前缀一字不动,把日期、变量这类会变的内容挪到会话末尾追加,命中率越高、省得越多。
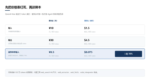
Qwen4-Max API定价(据阿里云百炼定价页,国内站口径)。
四、原生视觉与工具调用怎么接
Qwen4-Max原生支持图片与视频理解,并支持前缀补全、函数调用、缓存、结构化输出、联网搜索(据百炼文档,批量任务与微调暂不支持)。内置工具按次计费:代码解释器code_interpreter、网页抓取web_extractor、web_fetch免费;联网搜索web_search¥4/千次调用;以文搜图¥24/千次、以图搜图¥48/千次。
一个务实的组合是:需要事实时效时挂web_search,需要跑数或画图时挂免费的code_interpreter,需要稳定下游解析时用结构化输出(JSON Schema)。官方列举的落地案例可作能力上限参考——金融投研场景调用90个MCP工具获取A股、港美股数据并产出可溯源的Excel底稿与PPT报告;汽车制造场景把单个工件加工编程的人工投入从约475分钟降到24分钟(减少约95%);材料发现场景连续跑48小时、构建270万个分子候选空间,四轮闭环后拿到一个经实验验证的冷却液分子。这些均为厂商披露案例,未经第三方复现,宜当作方向而非承诺。
还有一个机制值得单独用:Live Delivery(实时交付),智能体先生成可用首版、再按反馈逐版扩展,配套插件已开源。做网站、报告、PPT这类”边看边改”的活时,比等它一次做完更可控。
五、算一笔真实的成本账
官方口径很吸引人:Work360评测中单任务平均费用从26.58元降至11.16元、降58%;Terminal-Bench 4.0上每次尝试的平均token从289K降到151K、近乎减半。
第三方更保守。据Artificial Analysis智能指数,Qwen4-Max(xhigh)为43分,比上代高9分、但比Kimi K3.1 Pro(max,46分)低3分;该机构实测的单任务成本降幅只有约11%。两个数都该看——差异来自任务构成与缓存命中率不同:官方58%建立在高缓存命中的Agent任务上,若你的场景上下文变化大、命中率低,降本就落不到自己账上。
同一款模型的两种降本口径,别抄进同一格。
给三类活的分流建议:长文档抽取、代码库问答、金融/法律底稿这类高重复上下文的任务,优先用Qwen4-Max并开满缓存;对时效敏感的调研任务挂web_search;纯闲聊或极简任务其实用不上旗舰,可等Qwen4系列中小尺寸开源档(官方称将陆续开源,时间与型号未定)再降本。
六、上手清单与三个待验证
一份最小可执行清单:①领百炼免费100万tokens;②用OpenAI兼容模式跑通qwen4-max并开enable_thinking;③把系统提示与长上下文固定为前缀、变量后置以吃缓存;④需要时效挂web_search、需要跑数挂code_interpreter;⑤用同一批真实任务做新旧对照,记录通过率与账单再切默认。
三个要自己验证的点:一是百万上下文能否用满、中间信息能否被准确调用;二是你的真实缓存命中率有多少,决定58%降本能否兑现;三是从预览版到正式版这五天改了什么——预览期曾有反馈提到多模态不一致、违背物理规律,正式版据说改善,但稳定性仍需在自己的任务上复测。
留言聊聊:你打算先拿Qwen4-Max跑哪类任务——长文档抽取、代码库问答,还是挂满MCP工具的金融投研?领了免费额度后,第一步准备怎么验证它的缓存命中率?

