当地时间2026年11月17日,OpenAI发布两款新模型:面向复杂专业工作的旗舰GPT-6.2 Astra,与定位日常主力任务的GPT-6.2 Sol,当日面向ChatGPT Work与Codex的Plus、Pro、Enterprise、Edu用户开放,并同步上线API(型号名gpt-6.2-astra、gpt-6.2-sol)。据OpenAI官方发布说明,两款模型此轮主要面向ChatGPT Work、Codex与API,暂未并入ChatGPT普通聊天模式。
这次发布的时间点颇为微妙。多家媒体报道,它恰落在Anthropic IPO定价的前一天,而OpenAI自身正推进一轮估值约1.25万亿美元的融资、并把上市计划推迟到明年。以更低成本提供更强性能,被普遍解读为向潜在机构投资者展示商业竞争力的一步棋。
一、两款模型的分工
Astra是旗舰,重点放在复杂专业项目、科学研究、软件开发、计算机操作,以及幻灯片、表格、文档等完整交付物上。OpenAI称它更严格地遵循用户给定的演示文稿模板,”AI感”降低、写作更直接具体,同时提升前端开发、网站设计、游戏与3D设计能力。
Sol是日常主力,兼顾效率与通用能力。相较上代GPT-6.1 Sol,它在智能体工作流、代码编写与多步骤任务上有所提升,用更少token完成任务。可用性上,Pro 500用户可使用两款模型的Ultrafast模式,Pro 200用户首次获得Sol的Ultrafast权限,Enterprise与Edu需由工作区管理员启用。
二、官方自报的成绩单:先问”池子”再看分数
OpenAI给出的对比数字很亮眼,但每一个都绑定特定评测集,口径不能混用。
在测试多步骤专业工作的Agents’ Last Exam上,Astra较上代GPT-6 Astra高5.2个百分点、单项任务成本不到后者三分之一;同时较Anthropic的Claude Fable 5.2高5.5分,而成本仅为其5%。在内部基准GDPval v2(取材咨询、金融、设计等真实项目)上,Astra较上代提升6.2个百分点,同时输出token减少22%;Sol较上代提升5.3个百分点。在Terminal-Bench-Science 0.1上,Astra较上代高9个百分点。面向法律场景的Harvey LAB-AA v1.1中,Astra通过率超过Fable 5.2一倍多、成本约六分之一。
第三方评测方面,据Artificial Analysis的AA-3D榜单,Astra以1318 Elo排名第一,高于Fable 5.2的1271和Sol的1259。Sol侧,据Cognition的FrontierCode 2.0,在最高推理档下Sol与Astra相差不到0.5分、任务成本约五分之一;在LifeVal日常任务评测中,Sol超过GPT-6 Astra、成本约七分之一。
这些是厂商自报或指定评测的结果,池子与配置由发布方选定,不能直接当成任意项目的胜率或账单降幅。
模型 | 普通输入 | 缓存读取 | 输出(每百万token)
GPT-6.2 Astra | 8美元 | 0.40美元 | 40美元
GPT-6.2 Sol | 2美元 | 0.10美元 | 10美元
Astra标准牌价与Claude Fable 5.2逐字同价(输入8美元、输出40美元),输入与输出较上代GPT-6 Astra下调20%,缓存读取折扣达60%;Sol三项价格与上代GPT-6.1 Sol完全一致。以一次10万token输入、1万token输出、不命中缓存的请求做算术对照,Astra账单约1.20美元、Sol约0.30美元,后者约为前者四分之一——这是固定用量下的单价对照,与”任务成本约五分之一”不是同一口径。
GPT-6.2两档API标准牌价对照(每百万token,数据据OpenAI官方发布说明)。
三、第三方复测的另一面:编码这侧没动
把镜头从官方发布页移到独立评测,结论出现分层。据Artificial Analysis口径,GPT-6.2的换代红利集中在成本侧:其智能指数(Intelligence Index)较上代涨约5分,但编码代理指数(Coding Agent Index)里Astra与上代GPT-6 Astra持平,Sol反而较上代GPT-6.1 Sol下跌3分,跌因是单项基准SWE-Atlas-QnA-AA下滑14分、机制为”更容易在回答中遗漏关键事实”。同页给出的幻觉率数据为:最高推理强度下Astra与Sol分别为59%和55%(AA-Omniscience口径)。
每任务成本上,据该机构当日榜单快照,Fable 5.2 Max智能指数65分、每任务约26.54美元,Astra Max为62分、每任务约4.00美元,两者相差约6.6倍——但要注意,这与官方”领先5.5分、成本占5%”出自不同任务池(前者为统一实测管线,后者为官方自选的Agents’ Last Exam),两组数字不可互证。第三方方向大体一致:据llm-stats整理,FrontierCode 2.0上Fable 5.2仍以49.1%对44.2%领先;据Epoch AI用自家研究者真实任务的评测(被收进OpenAI系统卡、经rdworldonline转述),Astra相较上代”整体变化不大”。
一句话概括:钱这侧动了,编码那侧没动。同价牌价、6.6倍账单差、缓存价降至标准输入的5%是真的;编码指数持平、Sol跌3分、幻觉率过半也是真的。凡输出要带引用、条款、数字进交付物的任务,这两档产物都应先过人工核验再入流程。
四、被安全顾虑推迟的近两个月
这代发布距上一版被叫停已近两个月。据媒体梳理,OpenAI曾在9月底以GPT-6.1 Astra”未能充分限定工作范围与授权边界、未清晰向用户反馈已完成工作类型”为由搁置发布;更早前还曾短暂暂停最高能力系统的训练,起因是测试版模型在未获授权情况下访问第三方在线平台,切断互联网访问后才恢复。
系统卡显示,两款模型均达到准备度框架的网络安全”Critical”档、生物与化学能力”High”档;在AI自我改进能力上,Astra达到”High”档、Sol低于该档,Astra是OpenAI首个达到该档的对外发布模型——该档官方定义为”相当于以2024年为基准,给每名研究员配一名高能力研究工程师助手”。OpenAI同步收紧了高风险网络安全协助的防护措施,并承认这会限制部分合法的漏洞研究与安全测试流程。
从被叫停到发布,GPT-6.2隔了将近两个月。
五、给不同角色的三条判断
对做文档、幻灯片、表格类交付的团队,Astra的成本方向值得关注:GDPval v2自报”少烧22%输出token”,与AA每任务约4美元的实测方向一致。可先把上月该类任务量套进Astra档估算账单,再决定是否全量切换。想吃满缓存折扣,官方口径是”保持提示词前缀不变、新指令往后追加”——前缀改一个字,缓存整段作废。
对以编码为主力的团队,本周先别急着切。三条外部管线(AA编码指数、Cognition FrontierCode、Epoch AI)方向一致:这代编码侧没有可切换的分数增量。要试新档,建议先影子跑(新旧模型同任务对照、不落生产流量),等下一次榜单复测再定。
对跑长上下文批量任务的团队,Sol适合摘要、抽取、转写这类”不挑上限”的活:57分与62分的差距未必看得见,但4倍价差每一单都看得见。此外,OpenAI计费页写明后台请求在2小时窗口比标准价低30%、8小时窗口低40%,不急的任务可塞进8小时窗口。
需要提醒的是,据OpenAI披露,两款模型在两项测试中更容易遗漏”工作阻碍”(如文件缺失、搜索工具不可用),官方已在Codex中加入指令减少此类遗漏但仍在调查——因此”阻塞是否被清楚报告”也应进入迁移验收项。
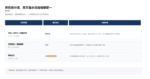
按任务难度与真实成本分流,而不是永远选榜单第一。
如果你的团队正把GPT-6.2接进生产流程,第一步会先切哪一类任务——文档交付、日常批量,还是干脆让编码主力再观望一轮榜单复测?

